


最新方法FFGo改变了我们对视频生成模型中第一帧的理解。第一帧并非简单起点,而是模型的「概念记忆体」,存储了后续画面的视觉元素。FFGo通过少量样本和特殊训练,激活模型的这种能力,实现高质量的视频定制,无需修改模型结构或大量数据,为视频生成开辟了新方向。
在Text-to-Video / Image-to-Video 技术突飞猛进的今天,我们已经习惯了这样一个常识:
视频生成的第一帧(First Frame)只是时间轴的起点,是后续动画的起始画面。
但马里兰大学、南加利福尼亚大学、麻省理工学院的最新研究发现:第一帧的真正角色完全不是「起点」,它其实是视频模型的「概念记忆体」(conceptual memory buffer), 所有后续画面引用的视觉实体,都被它默默储存在这一帧里。

- 论文链接:https://arxiv.org/abs/2511.15700
- 项目主页:http://firstframego.github.io
该研究的出发点,源于对视频生成模型中一个广泛存在但尚未被系统研究的现象的深入思考。
论文的核心洞察非常大胆:视频生成模型会自动把首帧中的角色、物体、纹理、布局等视觉实体,全部「记住」,并在后续帧中不断复用。
换句话说,不论你给多少参考物体,模型都会在第一帧悄悄把它们打包成一个「概念蓝图(blueprint)」。
研究者用Veo3、Sora2、Wan2.2等视频模型测试发现:
若首帧出现多对象组合, 在很少的情况下,通过使用特殊的转场提示词<transition>,模型在后续帧里能自然融合它们, 甚至能支持跨场景转场、保持角色属性一致;
但是这个神奇的转场提示词<transition>对于每个模型,每个要生成的视频都是不一样的,而且模型在转场融合多物体后常常会产生物体,场景一致性损失,或者物体丢失的问题。

这说明:
✔ 第一帧是模型「记忆」外来参考的地方
❌ 但默认情况下,这种能力「不稳定、不可控」
FFGo方法
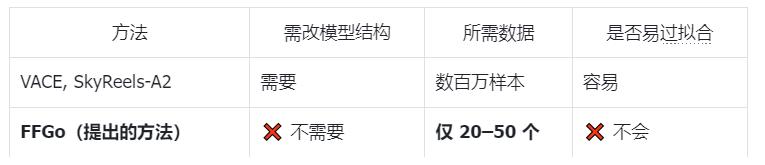
不改结构、不大规模微调,只用20–50个例子就能让任何预训练的视频模型变身强大的「参考图驱动视频定制系统」。
研究者基于这个洞见提出了一套极其轻量的做法 :FFGo。
关键优势震撼整个行业:
✔ 不修改任何模型结构
✔ 不需要百万级训练数据
✔ 只需 20–50 个 carefully curated 的视频例子
✔ 几个小时的 LoRA 训练
✔ 就能实现 SOTA 级别的视频内容定制
这在现有方法中几乎是不可想象的。
研究人员列出了6大应用场景:

- 机器人操作(Robot Manipulation)
- 自动驾驶模拟(Driving Simulation)
- 航拍/水下/无人机模拟(Aerial / Underwater)
- 多产品展示
- 影视制作
- 任意多角色组合视频生成
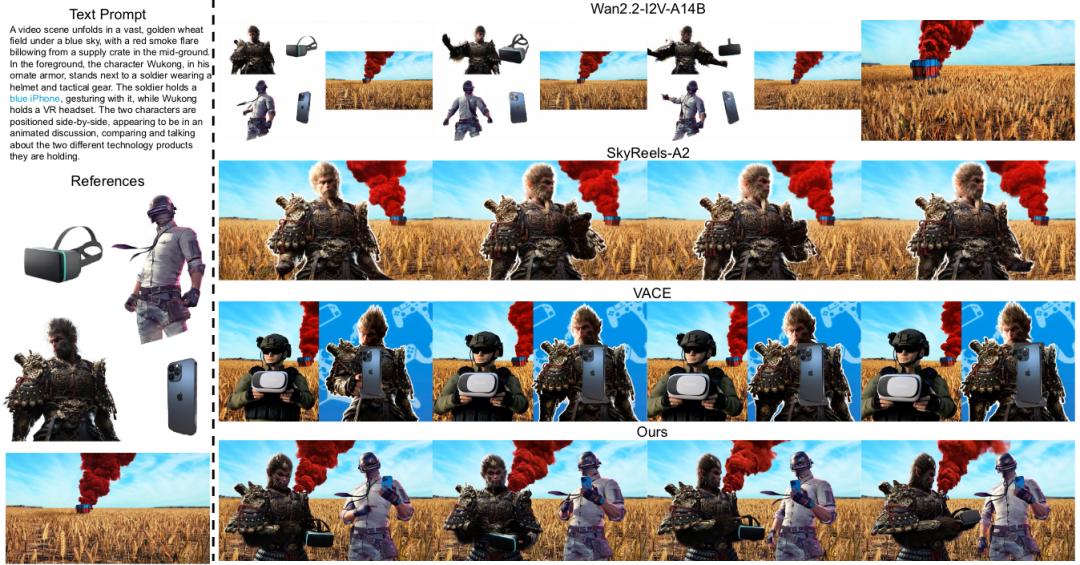
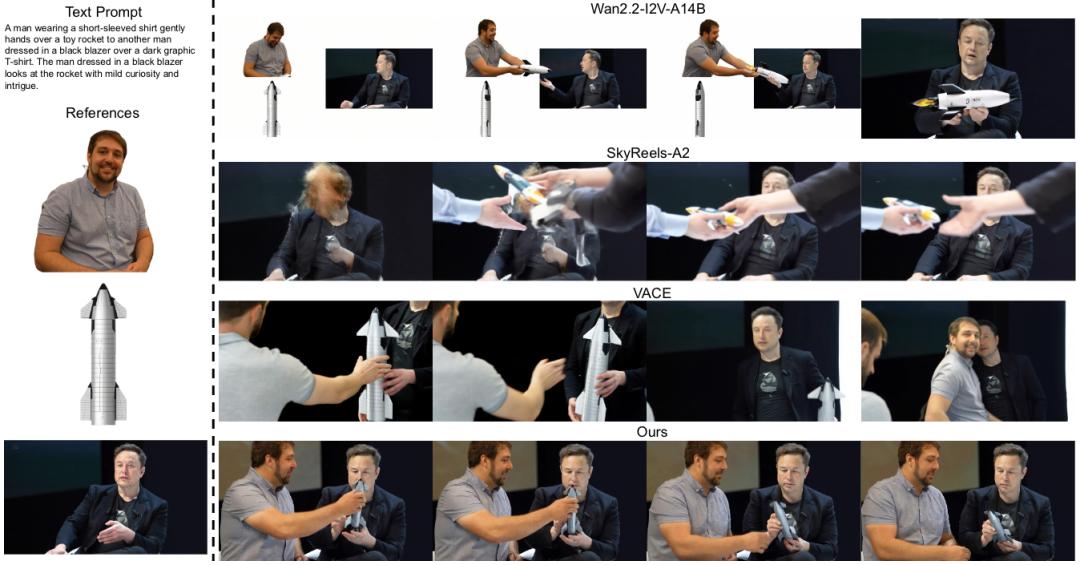
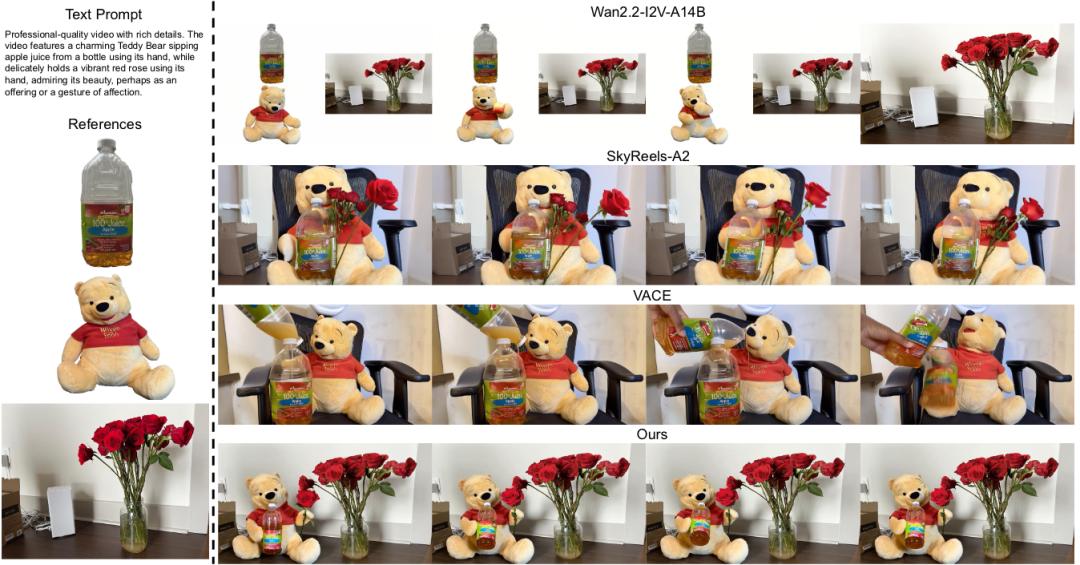
用户只需要给模型一张包含多个物体/角色的首帧,再配一个文本prompt,FFGo就能让模型自动「记住」所有元素并生成交互视频, 且画面一致性、物体身份保持、动作连贯都非常强,甚至支持「多达5个参考实体同时融合」,而 VACE/SkyReels-A2限制在3个以内,会直接漏物体。
技术亮点
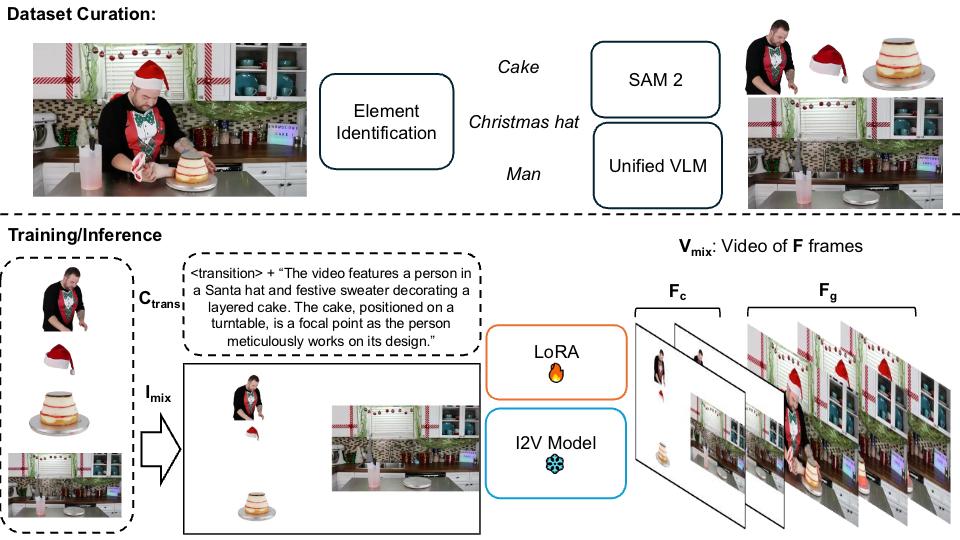
用VLM自动构建20–50条高质量训练集
用Gemini-2.5 Pro自动识别前景物体, 用SAM2提取RGBA mask, 自动生成视频文本描述,构建适配视频模型输入的训练样本, 这大大降低了手工工作量。
使用Few-shot LoRA激活模型「记忆机制」
研究发现:
- 模型天然具备融合多参考物体的能力, 但默认难以「触发」
- 一段特殊prompt(如「ad23r2 the camera view suddenly changes」)能起到「转场信号」的作用
- LoRA学到的不是新能力,而是「如何触发这些能力」,推理时只需丢掉前4帧(Wan2.2的压缩帧)
视频真正的混合内容在第5帧之后开始。前4帧是压缩帧,直接舍弃即可。
FFGo为什么这么强?
研究人员做了大量对比实验:
✔ FFGo 能保持物体身份一致性(Identity Preservation)
✔ 能处理更多参考对象(5个 vs 3个)
✔ 能避免大模型微调带来的「灾难性遗忘」
✔ 输出画面更自然、更连贯
特别是在多物体场景和通用的多物体互动场景下FFGo的生成效果显著优于VACE和SkyReels-A2。
基础模型偶尔「成功」,代表了什么?
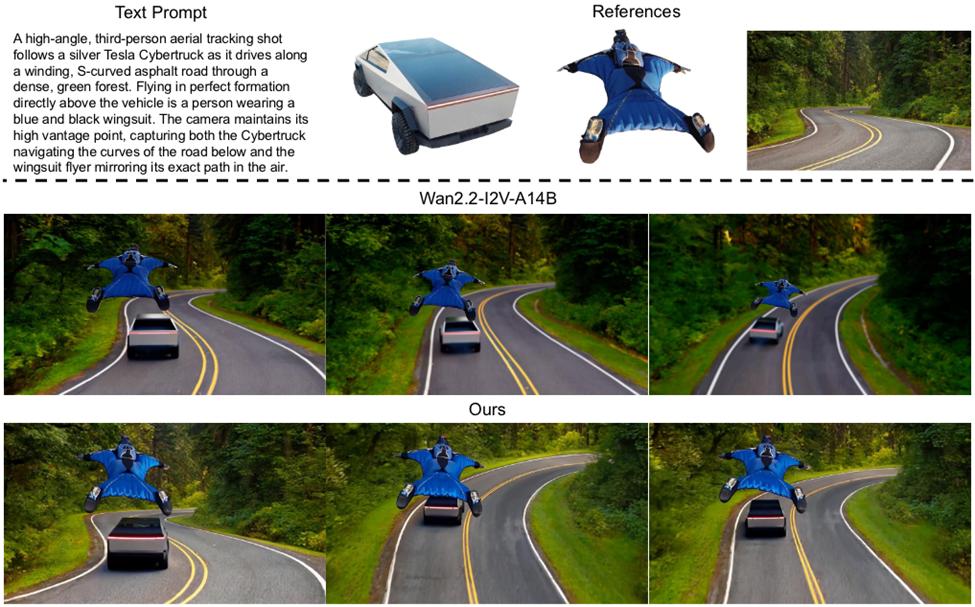
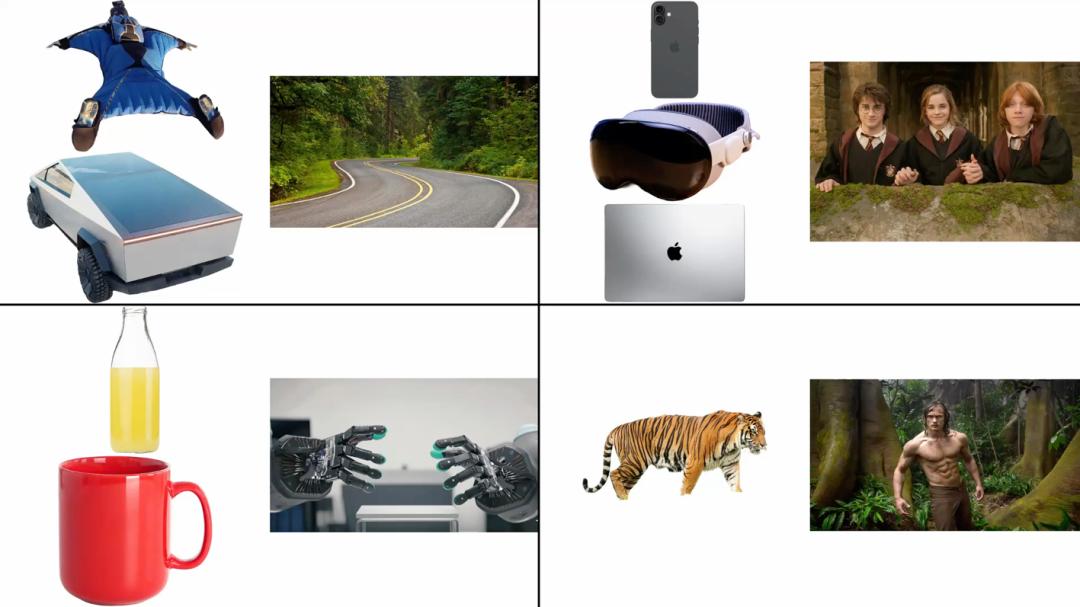
在研究FFGo的过程中,有一个特别关键的实验图示值得单独拿出来说:在偶尔的、极罕见的情况下,Wan2.2原始I2V模型也能完成一次「完美」的任务:
- 多个参考物体没有消失
- 场景转场保持稳定
- 动作连贯、身份一致
- 与文本提示(例如 wingsuit 飞行者与 Cybertruck 贴合运动)高度匹配
如果只看这一组结果,你甚至会以为原始模型本身就具备稳定的多对象融合能力。
但事实恰恰相反,成功的意义并不在于「基础模型表现很好」,而是在于:基础模型本来就「拥有」这种能力,只是大多数时候无法被稳定激活。
研究团队的洞察在这里被证实:
✔ 视频生成模型确实会把多个参考实体存进第一帧的内部记忆结构中
✔ 视频模型本身能执行「多对象+动作一致」的生成
✔ 但这种行为默认几乎不可控、不稳定、难复现
这就像模型体内藏着一块「隐藏 GPU」,偶尔会亮一下,但你完全不能指望它全天候工作。
FFGo不是教会模型新能力,而是让它「稳定发挥」
在上述对比中,FFGo的结果与原始模型的「偶尔成功结果」几乎一致,这说明:FFGo的LoRA不是在重写模型,而是在激活已有的潜在能力。
换句话说:原始模型=有潜力,但无法持续发挥,而FFGo=让潜力变成稳定能力(且不破坏预训练知识)
论文中提到,FFGo能保留原模型的生成质量,而不是像传统大规模微调那样牺牲泛化能力, 没有任何微调可以媲美预训练的数据质量和学习效果。
这个实验也证明了一件极具革命性的事:首帧本身就具备「概念记忆体」的角色、视频模型天生可以做多对象融合、关键只是缺乏一个「触发机制」。
FFGo做的就是:用几十条样本、一个精心设计的转场标记(transition phrase)、Few-shot LoRA,把这种能力重新「开机」,并且让它可控、稳定、可靠。
这也是为什么:FFGo能用20–50个样例,把SOTA模型甩在身后。
这个实验所传达的,本质上就是一句话:视频模型已经足够强,只是我们过去一直没有找到正确的用法。
而FFGo正是在教我们一件事:如何「正确使用」视频生成模型。
总结
用一句话概括这篇论文的研究意义:它不是让模型学会新能力,而是教我们如何使用模型已经拥有但从未被正确利用的能力。
研究人员提出了一个极具启发性的未来方向:
