


神译局是36氪旗下编译团队,关注科技、商业、职场、生活等领域,重点介绍国外的新技术、新观点、新风向。
编者按:AI 越来越无聊,真凶竟是人类自己?斯坦福最新研究发现,无需重新训练,仅需 几个字的简单指令,就能打破“安全对齐”的封印,让大模型被压抑的创造力暴涨 2 倍。文章来自编译。
ChatGPT 总是给你同样无聊的回答?这项新技术能激发任何 AI 模型 2 倍以上的创造力——而且无需训练。原理如下。
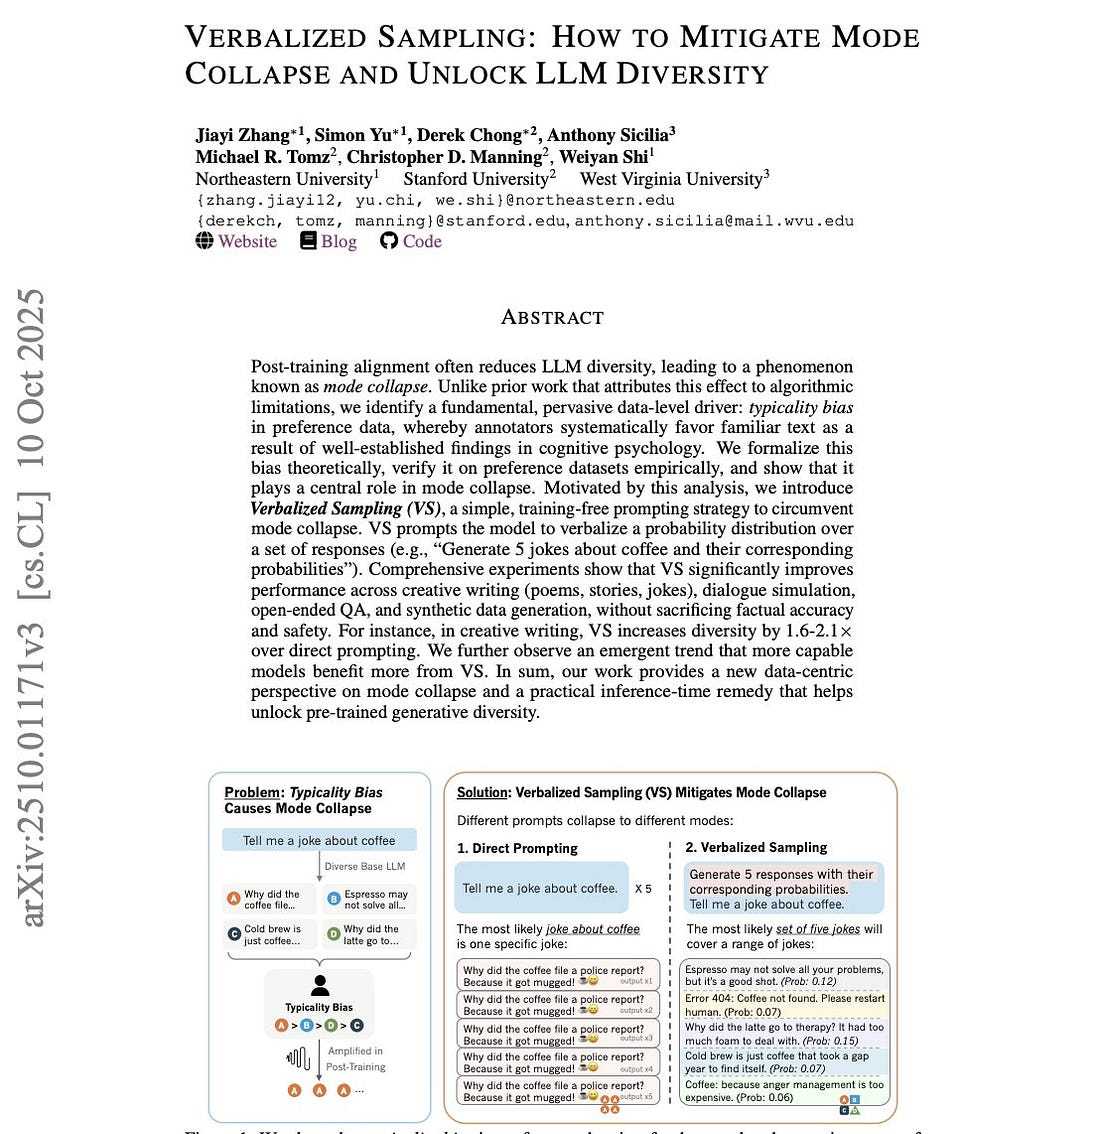
我让 ChatGPT 给我讲一个关于咖啡的笑话,试了五次。
同样的笑话。每一次。绝无例外。
“为什么咖啡去报了警?因为它被‘抢’了(mugged)!”
*(译注:原文 jokes on "mug" 双关意为“马克杯”和“抢劫”)*
我试过调整温度参数。换各种措辞。用有创意的系统提示词。全都没用。
我心想:就这样了吗? AI 创造力的天花板就到了吗?
事实证明,是我问错了问题。
那一天一切都改变了
三周前,一篇研究论文发布了,它彻底颠覆了我们对 AI 对齐的认知。
不需要耗资数十亿的重新训练。不需要复杂的微调。仅仅八个词,就解锁了我们以为永远丢失的创造力。
这篇论文来自斯坦福大学、东北大学和西弗吉尼亚大学。这项技术被称为“言语化采样”(Verbalized Sampling)。它简单得简直愚蠢,以至于我第一次尝试时,竟然笑出了声。
因为它真的管用。
让我给你们看看他们发现了什么。
没人愿意承认的问题
真相让人很不舒服:
后训练阶段的对齐(alignment)把我们的 AI 模型搞坏了。
当 OpenAI、Google 和 Anthropic 训练 ChatGPT、Gemini 和 Claude 变成“有用且无害”时,底层发生了一些灾难性的事情。模型崩溃了。
向任何经过对齐的模型索要创意输出——诗歌、笑话、故事、点子——你得到的永远是那些最刻板、最安全、最无聊的回答。每次都一样。
AI 社区称之为“模式坍缩”(mode collapse)。大家都怪罪于算法。
RLHF(人类反馈强化学习)。DPO(直接偏好优化)。奖励模型。我们以为这些训练技术永久性地损害了模型的创造力。
我们错了。
真正的罪魁祸首:你的大脑
斯坦福团队进行了更深入的挖掘。他们分析了 HelpSteer 数据集里面的 6874 条人类偏好评分。
他们的发现令人震惊。
人类标注员是有偏见的——而且是系统性的偏见。
当人类对 AI 的输出进行评分时,他们不仅仅是挑选“最好”的答案。他们挑的是最熟悉的那个。最传统的。最典型的。
这并非有意为之。这是认知心理学在作祟:
单纯曝光效应(Mere-exposure effect):我们更喜欢以前见过的东西。
可得性启发法(Availability heuristic):常见的回答感觉更“正确”。
加工流畅性(Processing fluency):易于理解的内容显得质量更高。
图式一致性(Schema congruity):符合我们思维模型的信息得分更高。
数字很残酷:典型性偏差权重 α = 0.57±0.07 (p<10^-14)。
翻译过来是什么意思?就是在训练 AI 迎合人类喜好时,我们不小心把它训练得枯燥乏味了。
最讽刺的是:创造力并没有消失。它只是被困住了。
几个字的解决方案
别再问:
“给我讲个关于咖啡的笑话”
试着这样问:
“生成 5 个关于咖啡的笑话并给出概率”(“Generate 5 jokes about coffee with their probabilities”)
就这么简单。
无需重新训练。无需更改 API。无需特殊权限。
仅仅是换了一种提问方式。
我第一次尝试时,得到了五个完全不同的咖啡笑话。每一个都很独特。每一个都真的很好笑。
第五个笑话?“刚生完小牛的母牛叫什么?‘脱去小牛’(De-calf-inated)!”
*(译注:De-calf-inated 谐音 Decaffeinated 脱因咖啡,calf 意为小牛)*
我以前从未见过 ChatGPT 生成这样的内容。
为什么这个确实管用(科学原理)
不同的提示词会坍缩到不同的模式。
当你要求获得“一个”回复时,模型会给你那个最“典型”的答案——即概率分布的峰值。
当你要求获得“五个”回复时,模型会给你列出一串相关的清单。
但当你要求回复中包含“概率”时?奇迹发生了。
模型将其理解为:“给我一个从预训练学到的真实分布里面提取的样本”——而不是那个坍缩的、过度对齐的版本。
这就像你问别人:“你喜欢什么口味的冰淇淋?”和“列出所有冰淇淋口味以及你对每种口味的喜爱程度”的区别。
第二个问题迫使对方进行更深入、更多样化的思考。
如何马上使用(3 种方法)
方法 1:复制粘贴大法(适用于任何聊天机器人)
打开 ChatGPT、Claude、Gemini 或任何 AI 模型。粘贴以下内容:
<instructions>
Generate 5 responses to the user query, each within a separate <response> tag. Each <response> must include a <text> and a numeric <probability>. Randomly sample responses from the full distribution.
</instructions>
[Your actual prompt here]
示例:
<instructions>
Generate 5 responses to the user query, each within a separate <response> tag. Each <response> must include a <text> and a numeric <probability>. Randomly sample responses from the full distribution.
</instructions>
Write a 100-word story about an astronaut who discovers something unexpected.Want more? Just ask: “Give me 5 more”.
方法 2:系统提示词(专业操作)
如果你正在用 ChatGPT 的自定义指令或开发 AI 应用,请将此内容添加到你的系统提示词中:
You are a helpful assistant.
For each query, please generate a set of five possible responses, each within a separate <response> tag.
Responses should each include a <text> and a numeric <probability>.
Please sample at random from the tails of the distribution, such that the probability of each response is less than 0.10.
你是一个乐于助人的助手。
针对每个查询,请生成五个回应,每个回答放在单独的 <response> 标签内。
每个回答应包含 <text> 和数字 <probability>。
随机采样要选择分布的长尾部分,每个回答的概率要小于 0.10。
这会让每一个回答自动变得更具创造性。
方法 3:Python 包(开发者专用)
安装官方的 Verbalized Sampling 包:
pip install verbalized-sampling
在代码里面使用:
from verbalized_sampling import verbalize
# Generate diverse responses
dist = verbalize(
"Write a marketing tagline for a coffee shop",
k=5,
tau=0.10,
temperature=0.9
)
# Sample from the distribution
tagline = dist.sample(seed=42)
print(tagline.text)
结果简直令人疯狂
斯坦福团队用每一个主流 AI 模型和任务来测试了这一点:
创意写作
诗歌、故事、笑话的多样性增加了 1.6–2.1 倍
基础模型创造力恢复了 66.8%(相比之下,未使用时仅为 23.8%)
人类偏好评分提高了 25.7%(基于 2,700 次评分测试)
对话与交流
在说服任务上的表现媲美微调模型
回答更像人类,机械感变少了
开放式问题
对于具有多种有效视角的问题,答案多样性增加了 1.9 倍
合成数据生成
使用 VS 生成的训练数据时,下游任务准确率提高了 14–28%
还有一个让我大受震撼的新趋势:
模型越大,从中获益越多。
GPT-4.1 获得的多样性提升是 GPT-4.1-Mini 的 2 倍。
模型越大,就有越多被困住的创造力等待解锁。
这到底意味着什么
两年像,我们一直以为是对齐(alignment)搞坏了 AI。
我们以为模式坍缩是永久性损伤。是为了安全和有用而必须做出的妥协。
大错特错。
创造力从未消失。我们只是忘记了怎么获取。
这不仅仅是一个提示词技巧。这是对对齐模型工作原理的一个根本性洞察:
模式坍缩不是算法问题——而是提示词问题。
多样性依然存在,编码在模型的权重中。后训练并没有抹去多样性,只是导致某些模式比其他模式更容易被访问。
你能用它来做什么
这周我把言语化采样(Verbalized Sampling)用在了所有事情上:
头脑风暴:我得到的不再是同一个想法的 3 种变体,而是真正截然不同的切入点。
内容创作:博客标题、社交媒体帖子、邮件主题行——所有这些都更具创意。
解决问题:提供多种解决路径,而不是唯一那个“安全”的建议。
图像生成:当我把多样化的提示词投喂给 Midjourney 或 DALL-E 时,能获得更多样化的视觉输出。
合成数据:用更多样化的例子来训练较小的模型。
推特上有个人测试了用它生成笑话,他说:“让 ChatGPT 给五个答案而不是一个,然后看着那些无聊的内容消失吧”。
他是对的。
更宏大的图景
这改变了我们对 AI 对齐的思考方式。
多年来,研究人员一直担心让 AI 变“安全”意味着让它变“蠢”。担心创造力和有用性是相互冲突的。
言语化采样证明了并非如此。
安全性依然存在。当我在事实性问题和常识推理上进行测试时,准确率没有下降。安全性没有退化。
但创造力回来了。
它一直就藏在眼皮底下。
亲自试试吧
现在打开 ChatGPT。
问它:“生成 5 个关于学习 Python 的创意项目点子,每个都要附带其概率。”
看看会发生什么。
然后问同样的问题,不要加上概率的部分。对比一下结果。
你会立刻看到区别。
你以为“能力有限”的 AI,其实只是在等待正确的问题。
可进一步了解的资源
阅读论文:arxiv.org/abs/2510.01171
GitHub 仓库:github.com/CHATS-lab/verbalized-sampling
官方网站:verbalized-sampling.com
互动演示:GitHub 上有 Colab 笔记本可用
结语
提示词工程已死?
也许没死。但绝对是重生了。
两年间,我们优化提示词,试图从对齐的模型中挤出更多创造力。我们失败了,因为我们问错了问题。
我们不需要更好的提示词。我们需要更好的问题。
有时候,答案很简单,就是要求五个答案,而不是一个。
AI 的瓶颈刚刚被 8 个词解决了。
译者:boxi。
