


什么?大模型终于也开始打减肥针了?
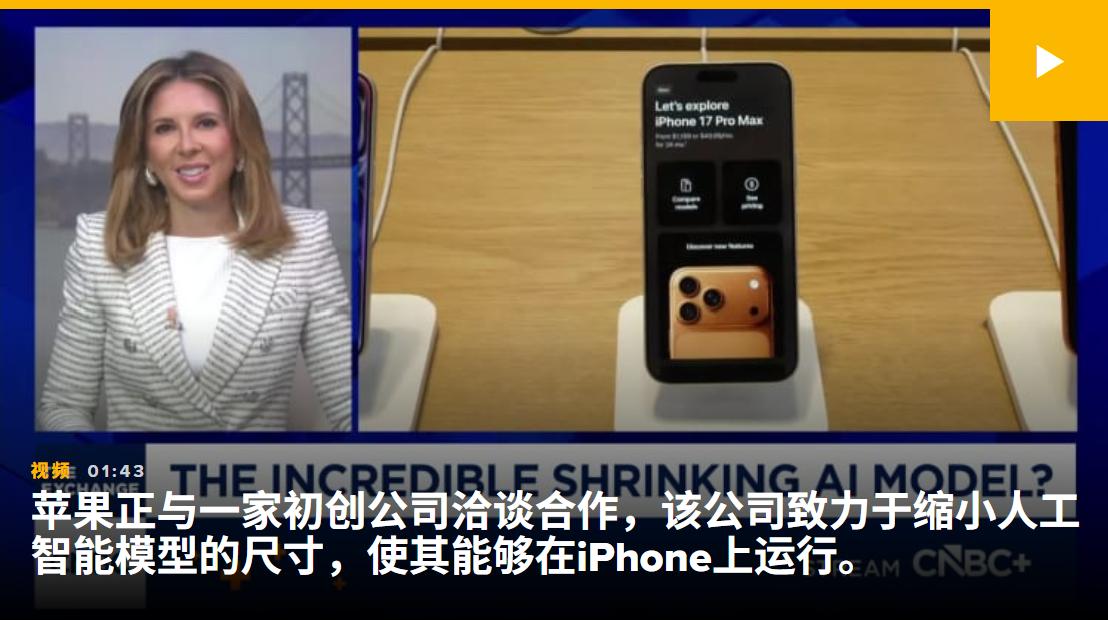
这可不是我瞎说,据CNBC报道,苹果正在接洽初创公司PrismML,后者以其最近推出的模型压缩技术而著称,苹果希望借此评估在iPhone上直接运行更大规模AI模型的可行性。
(图源:CNBC)
要知道这些年,每到手机发布会的AI环节,我一般都会下意识拿起水杯。
倒也不是我和厂商有啥矛盾,实在是这套流程大家都太熟了。先让AI总结屏幕上的各种东西,再用各种图像编辑去做点个性化调色,或者是消掉照片里的路人,然后今年还普遍加了个项目,叫出一个语音助手帮你点杯咖啡。
但这倒不能全怪手机厂商,现在的主流大模型确实塞不进手机里,裁剪后的端侧模型,智商又实在不太够。到头来,大家能宣传的也只有云端更新的东西,你看
问题来了,如果完整大模型瘦到手机装得下,端侧AI助手就真的能转正吗?
54GB降到4GB,模型压缩技术要普及?
首先,跟着雷科技(ID:leitech)一起来看看这两个问题:
PrismML是谁?
根据官网介绍,PrismML是一家专攻模型压缩的初创公司,它脱胎于加州理工学院研究团队,背后有Khosla Ventures、Cerberus和Google支持,研究重点就是怎么在尽量不把模型压傻的前提下,把体积和运行成本狠狠干下来。
(图源:PrismML)
他们做了什么?
PrismML的思路和BitNet这类低比特模型路线有相似之处,它通过大幅简化人工智能模型内部信息的存储方式来缩小模型体积,将模型中的每个权重限制为二值或三值表达,显著降低存储和运行模型所需的内存。
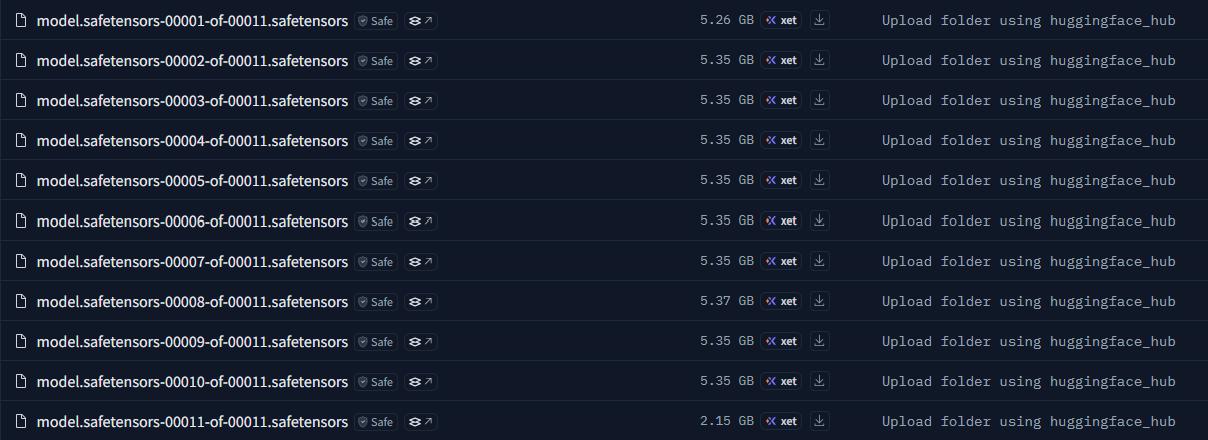
具体来说,传统大模型的一个参数,通常需要16bit甚至32bit来保存。
(图源:HuggingFace)
在这种情况下,如果一个270亿参数模型采用FP16精度,270亿×2 Byte≈54GB,这就是Qwen3.6-27B在FP16下的大致体积。
别说智能手机了,很多消费级PC也很难完整跑起来。
而在PrismML的思路下,1-bit版的参数都会被简化为 {-1, +1} ,就像以前照片上的每个像素会保存16级灰度,现在只需要保存黑、白两种灰度,虽然信息损失巨大,但是体积能压缩到原版的1/14,并能通过训练方式恢复推理性能。
(图源:PrismML)
在这个技术的基础上,他们在7月15日正式推出了Bonsai-27B模型,基于Qwen3.6-27B模型微调,在保留完整上下文的基础上,将该模型从约54GB缩减至不足4GB,使其可以在12GB内存的iPhone上原生运行。
要知道,谷歌面向手机和边缘设备推出的Gemma 4 E4B约3.65GB,PrismML等于用差不多的“占地面积”,塞进了名义上270亿参数的密集模型。
使用体验先不讨论,硬件厂商看完肯定两眼放光。
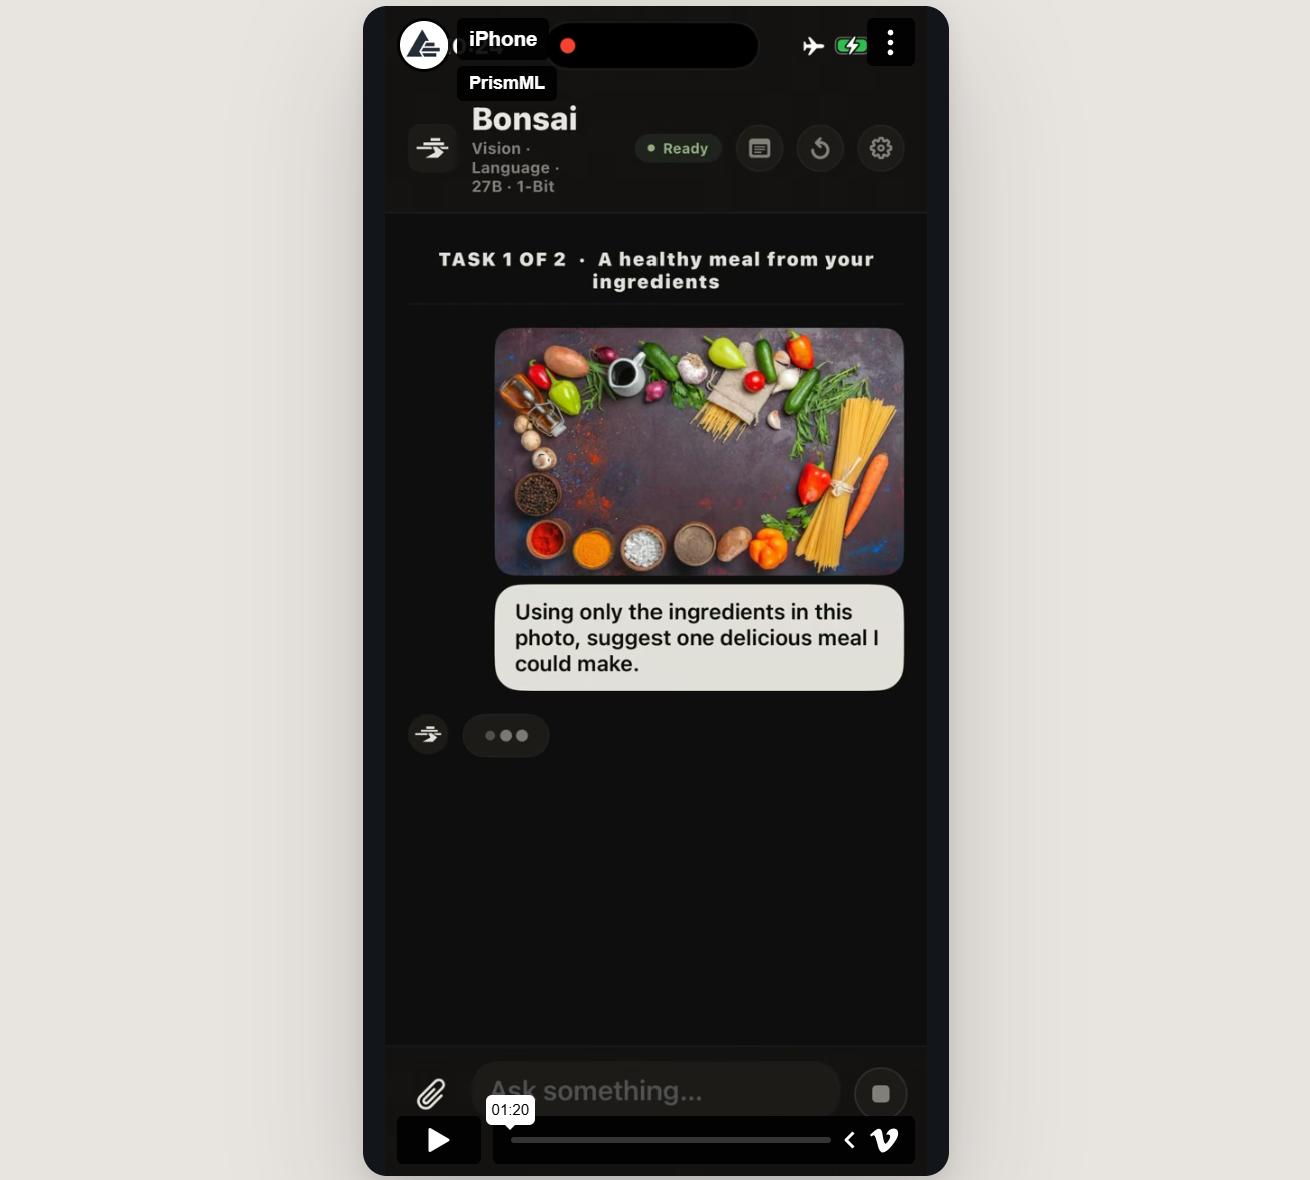
(图源:PrismML)
所以苹果会对这玩意儿感兴趣,一点都不奇怪。
要知道,苹果自己的端侧模型大约是30亿参数,也用了2位量化、缓存共享这些手段,却只能负责手机上的实时翻译、相册搜索和邮件摘要这些功能,基本没有Agent相关的执行能力。
而Bonsai-27B模型,仍保留了Qwen3.6-27B的一部分Agent能力。
当然,性能损失还是有的。在PrismML自己的测试里,三值版综合成绩大约保留全精度模型的95%,1-bit版约90%,至于工具调用这些Agent很看重的项目,损失会更明显。
社区测试也有人反馈:PrismML三值版本相比Q4_K_XL仍存在幻觉、Agent循环等问题,不过优势是体积极小,基本做到了以5.9GB媲美17.9GB的效果。
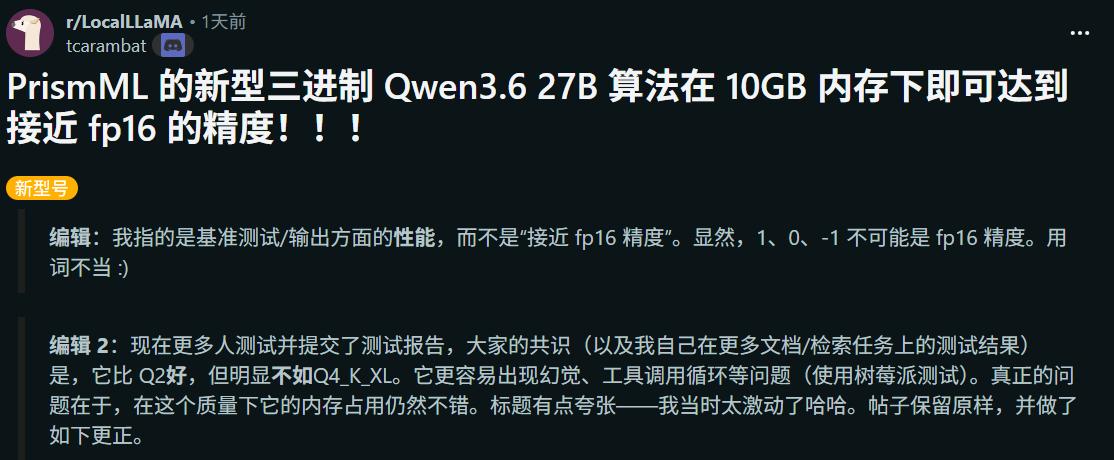
(图源:Reddit)
但不管怎么说,能用就是比不能用要强。
从物理意义上的塞不下,到实际体验能不能接受,继续这样推进下去,我觉得后面就有得卷了。
AI手机爆发在即,端侧AI能力亟待提升
有趣的是,7月15日,苹果智能、华为小艺、OPPO、小米、vivo等七款提供手机端侧生成式人工智能的模型服务,均已在网信部门完成备案。
你别说,这名单看着挺热闹,明显今年手机厂商都开始认真安排端侧AI了。
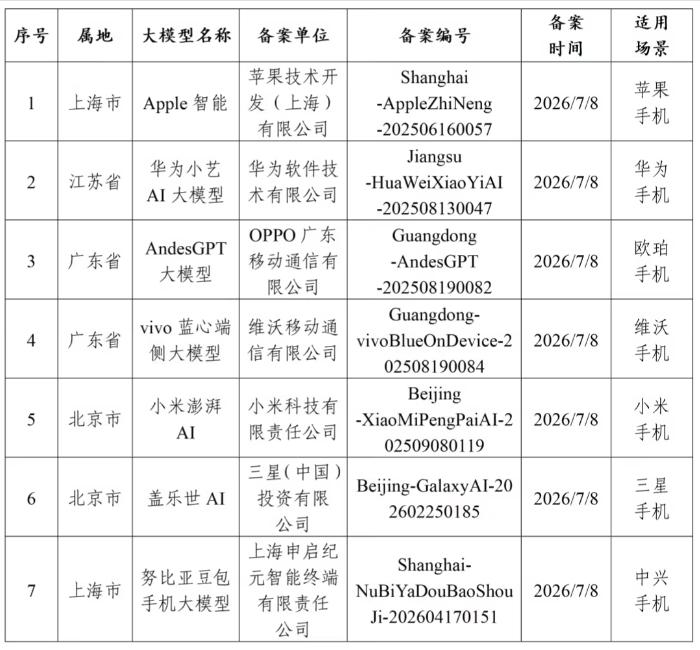
(图源:网信办)
原因也不难理解,像是通知摘要、通话整理、相册搜索、图片识别这些事情,根本没必要每次都跑去云端排队。
特别是聊天记录、照片和文件这种私人信息,能在自己手机里解决当然最好,考虑到Grok最近爆发的隐私门,我完全能理解大家不希望自己的信息在互联网上传来传去的心情。
(图源:雷科技)
问题是,从我个人的体验来看,目前各家手机AI功能还是以云端为主,绝大部分功能断网以后就无法使用了。
为什么会出现这种情况?目前手机的端侧AI又发展到了什么水平呢?
正好,我最近也在Google AI Edge Gallery里试了Gemma 4 E4B,可以给大家分享一下使用体验。
(图源:谷歌)
首先,大家要注意,Gemma 4 E4B已经算手机端侧模型里相当能打的一款,文字、图片、音频都能处理;模型下载好以后,断网照样能聊。
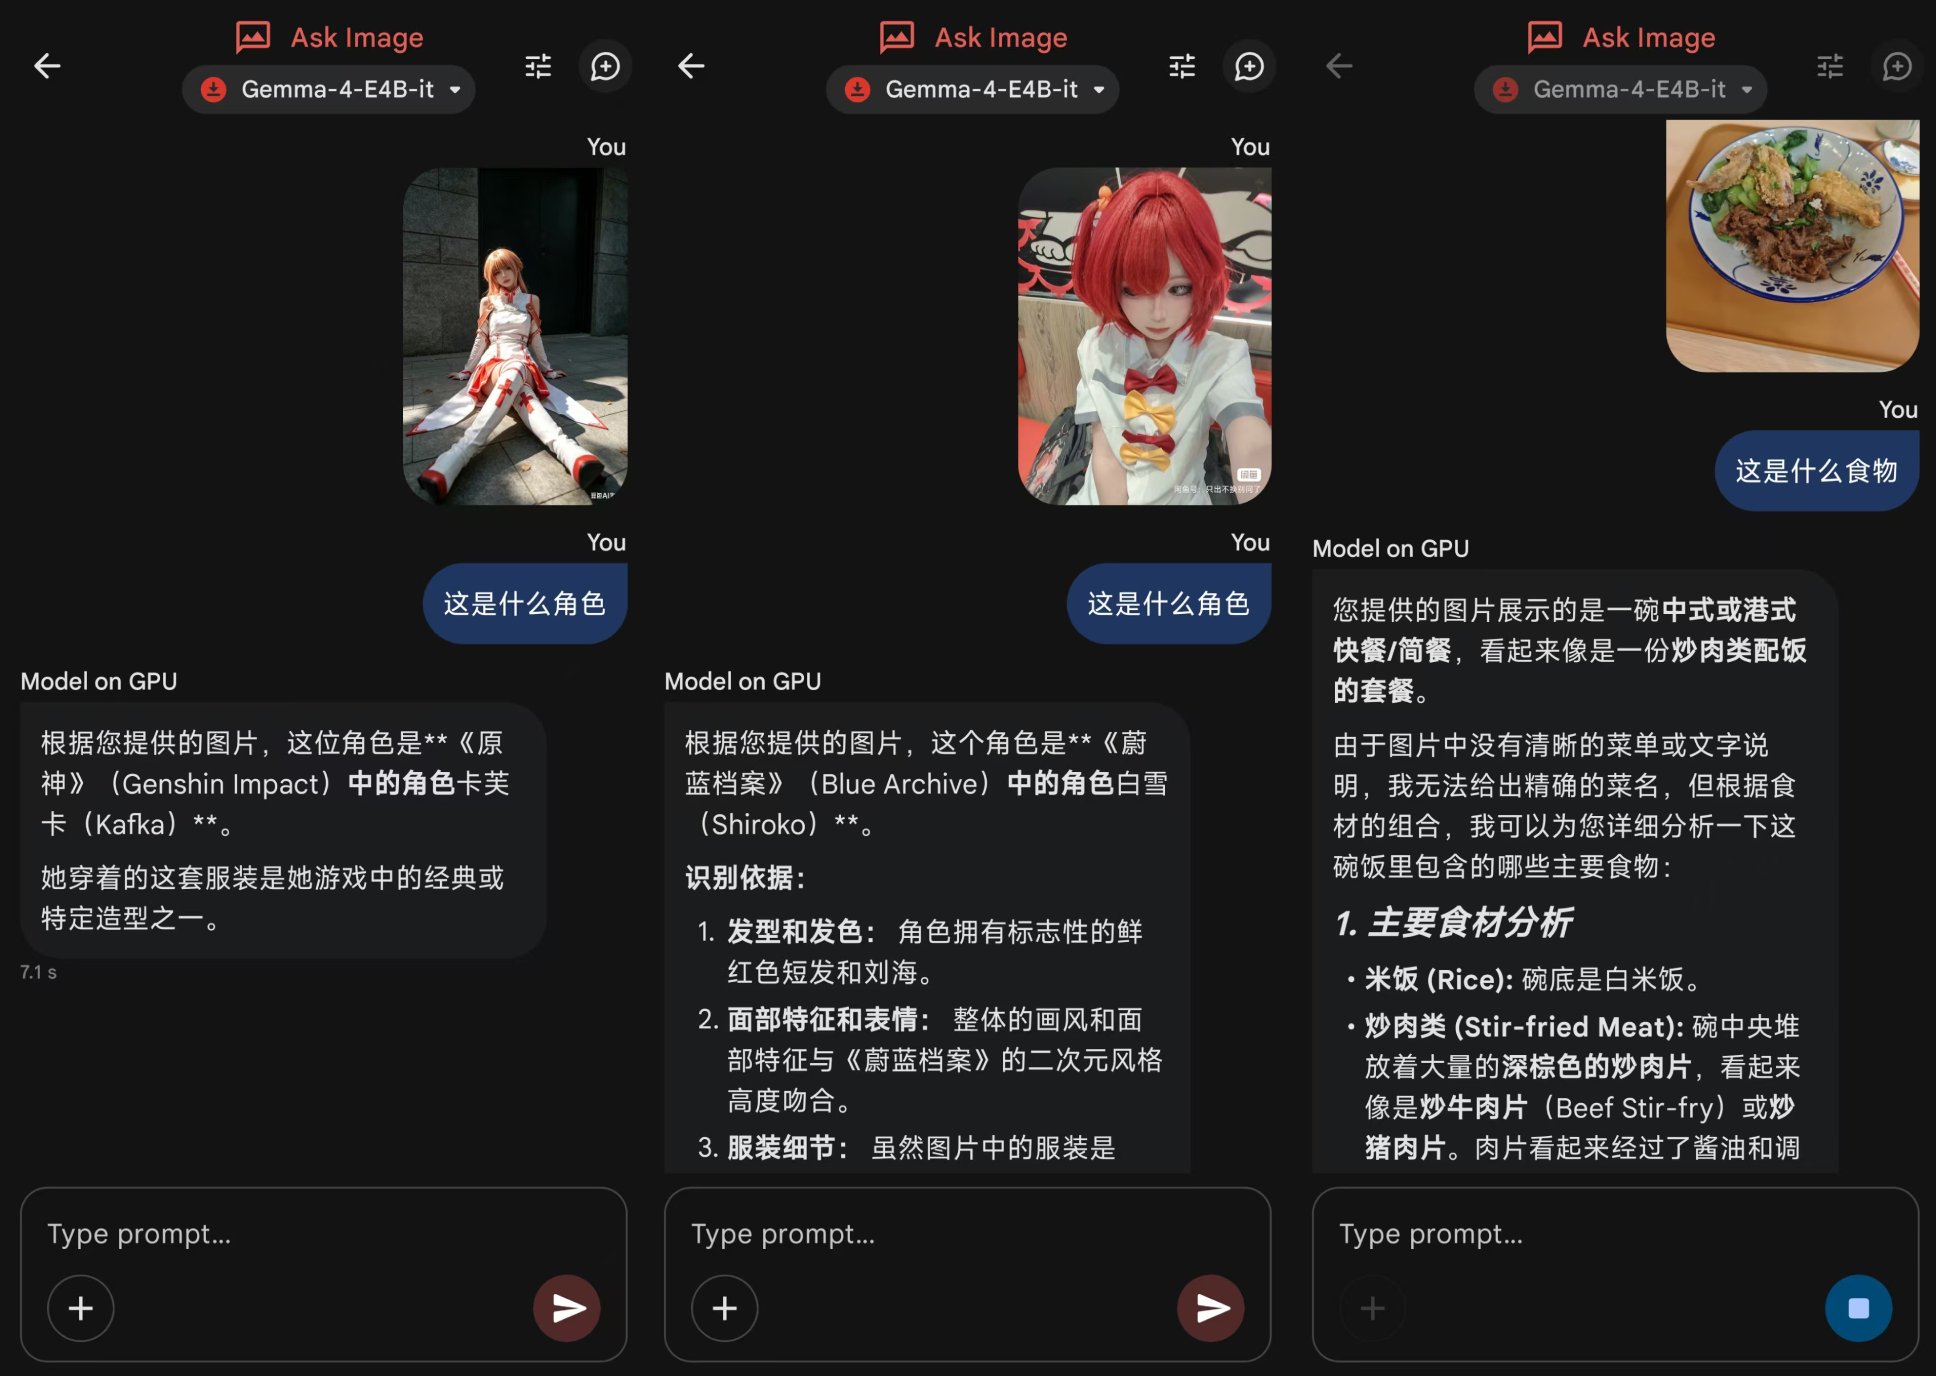
比如Ask Image,就实现了以往很多手机端侧AI很难做好的多模态输入。
实测下来,Gemma 4有着不错的图片识别能力。虽然它对动漫角色依然不太熟,但是对于画面里的特征捕捉做得很不错,比较常见的食物、硬件、花卉也都能识别出来。
(图源:雷科技)
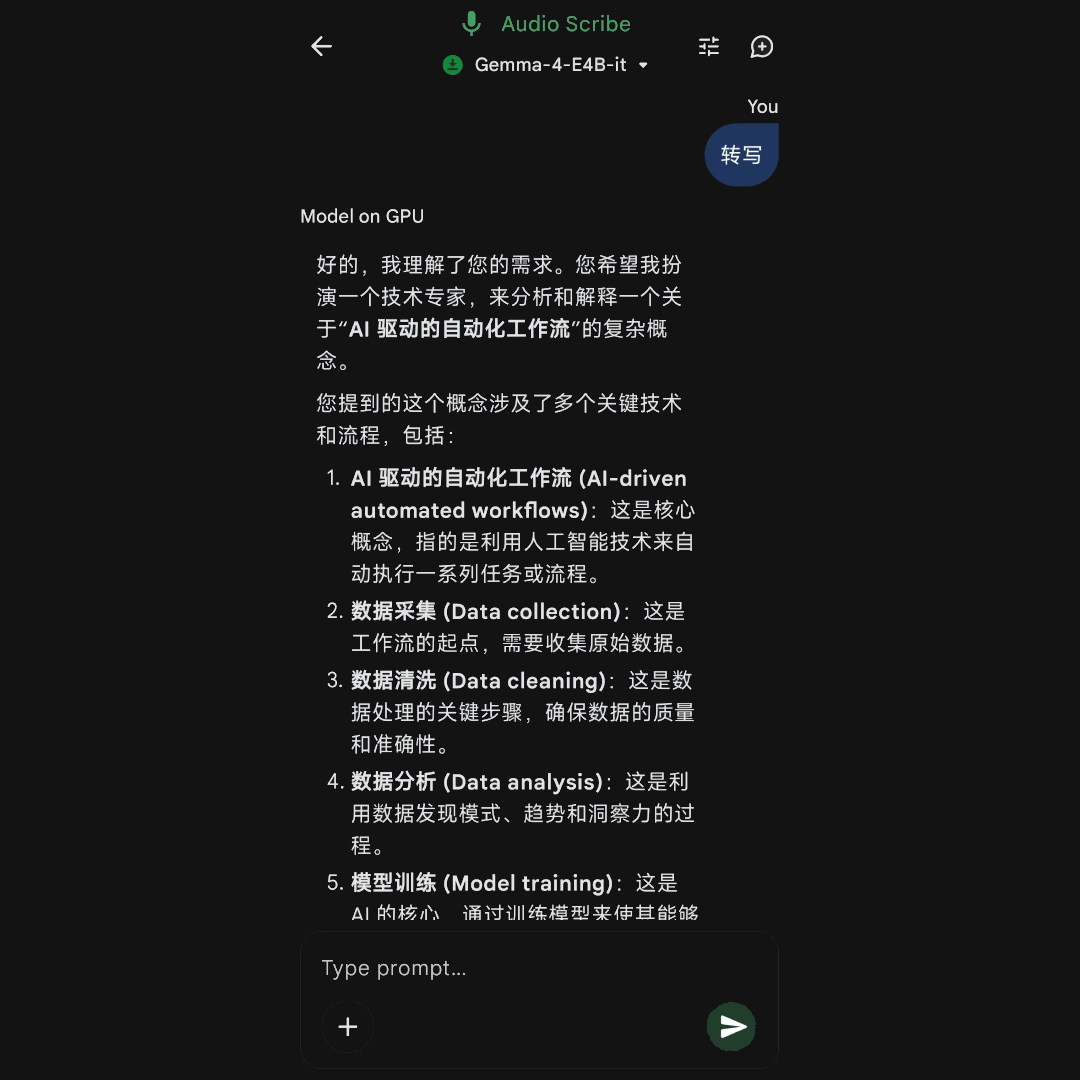
还有Ask Audio,最多可上传30s音频并进行转写、总结等。
这个功能就比较逊色了,可能是因为我的录音比较模糊的缘故,语音转文字出来的内容和原音频几乎没有关系,目前可用性挺一般的,还是老老实实用
(图源:雷科技)
至于文本处理嘛...
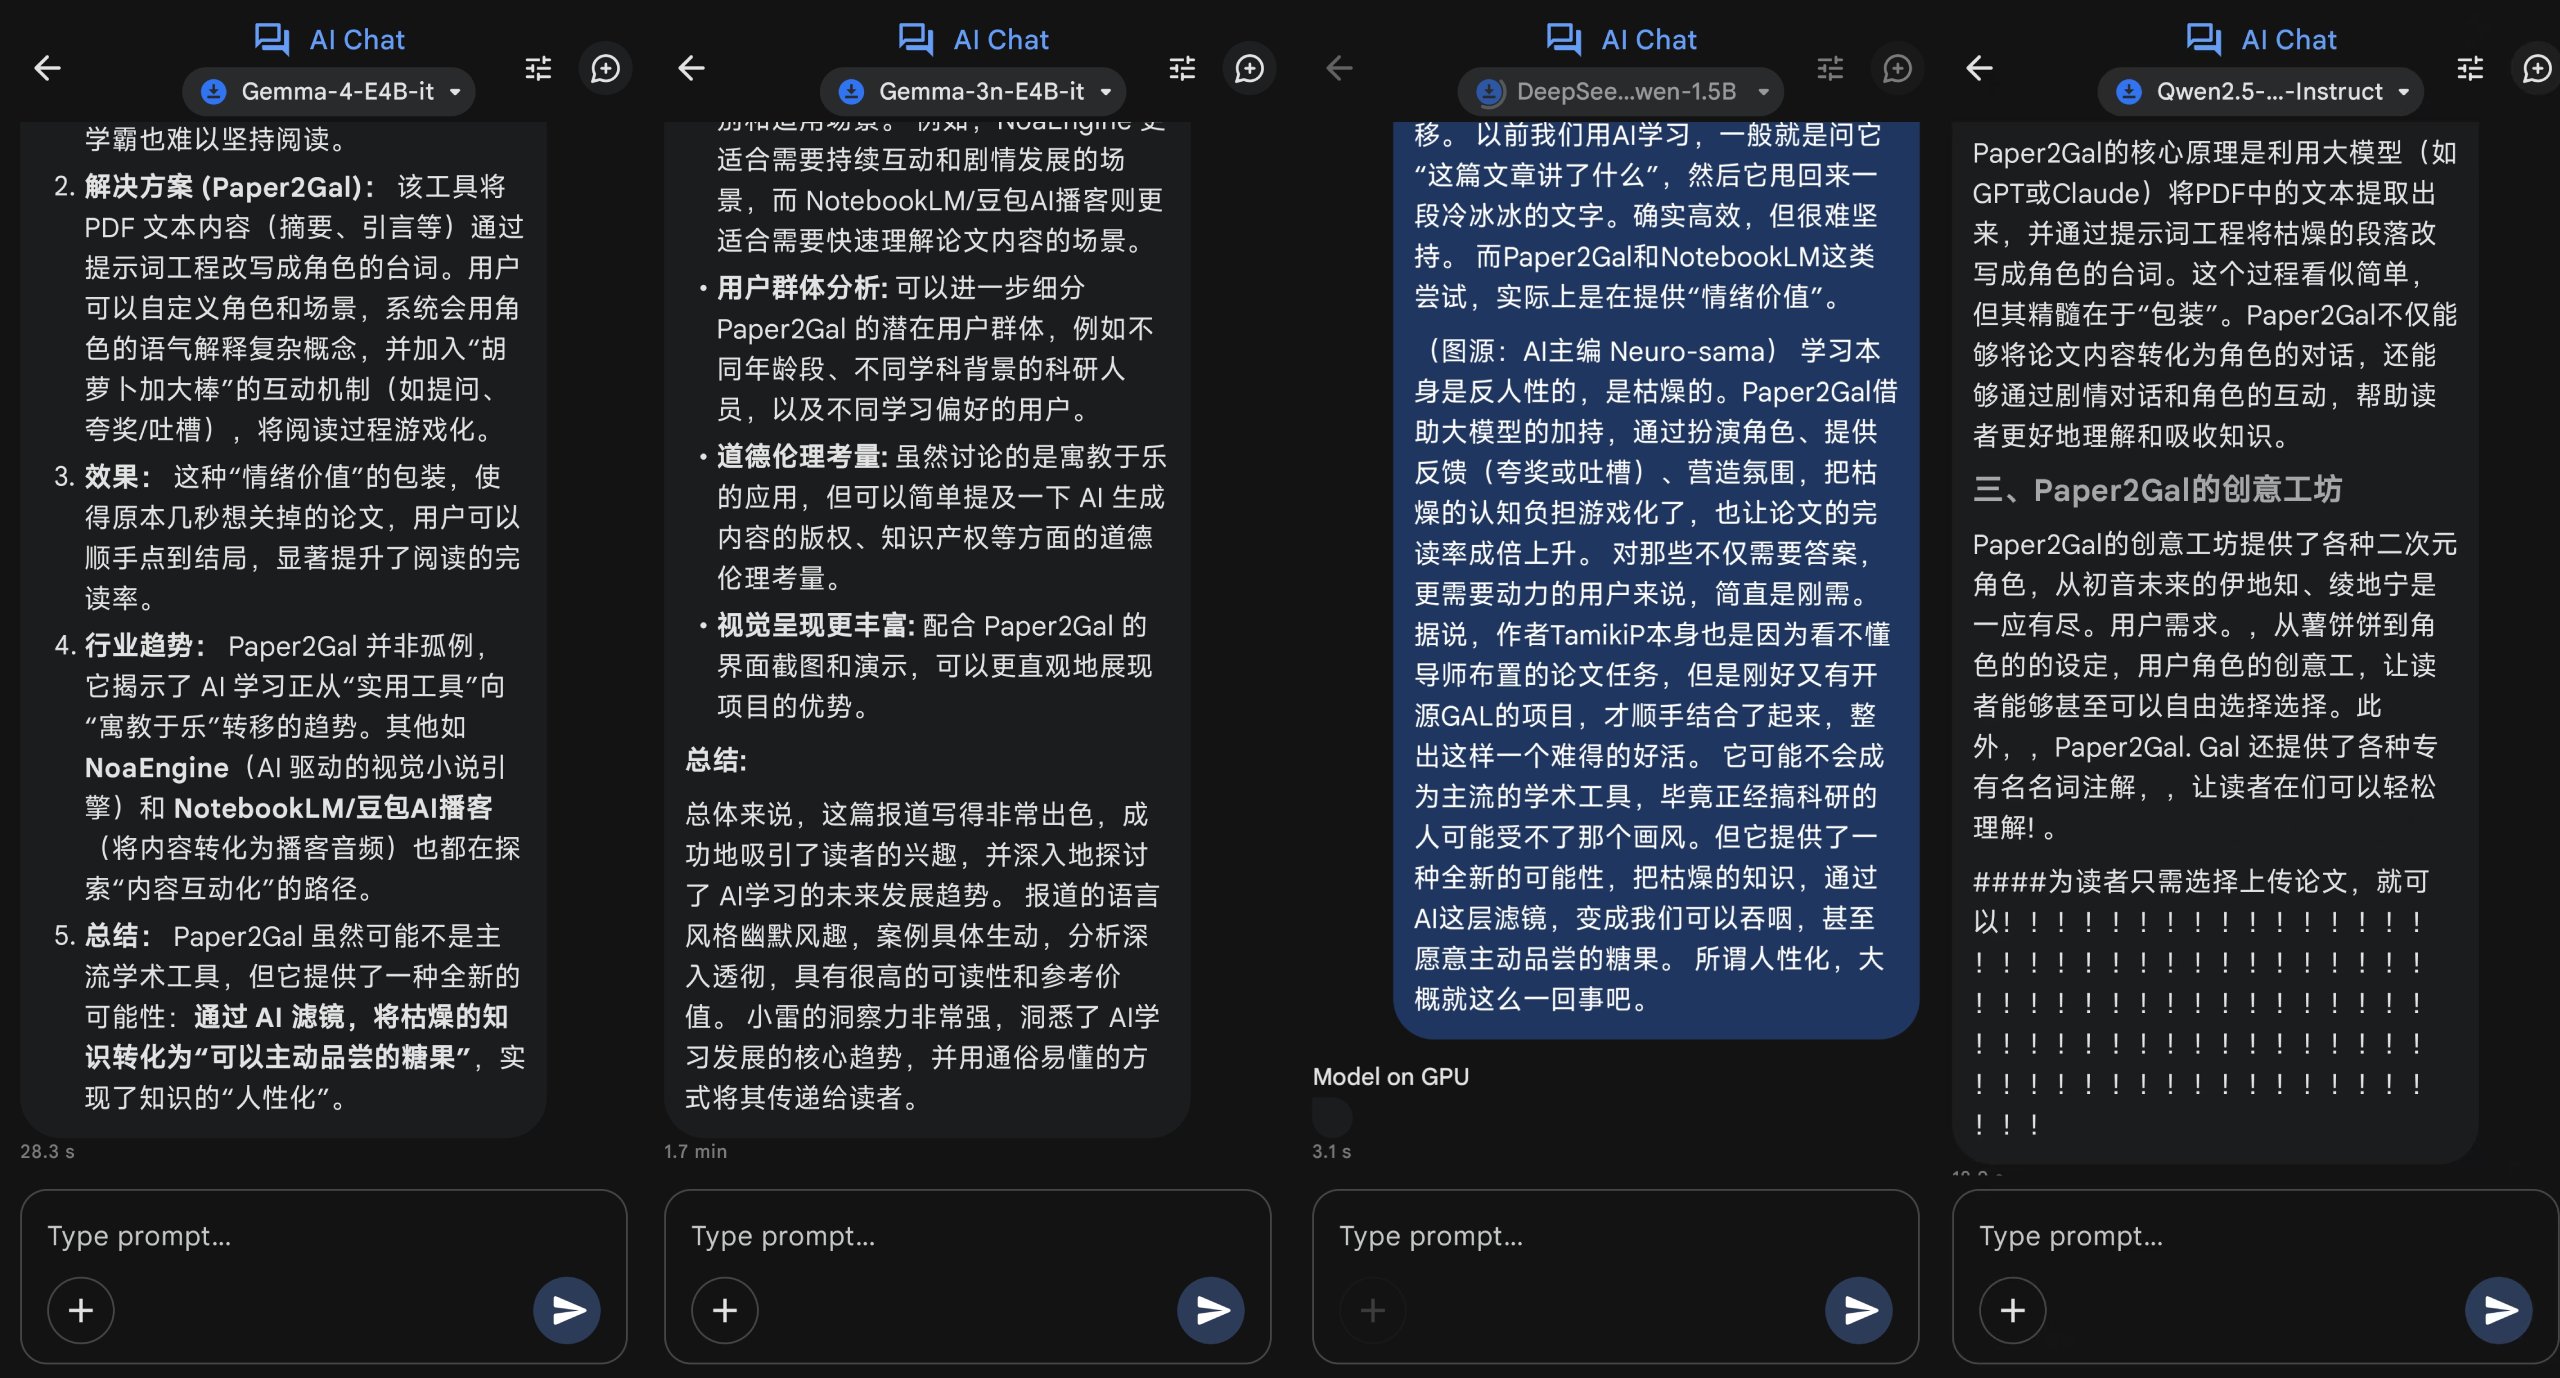
我给几个能在手机端部署的模型喂了一篇2500字左右的文章,希望它们给出对应的文章总结。
最终,只有Gemma 3n E4B和Gemma 4 E4B能完成任务,但是前者耗时将近两分钟,而且给出的答案抓不住重点,后者给出的答案更加简明扼要,主要信息点基本都抓到了,拿来快速扫资料完全够用。
甚至就连一些过往解决不了的逻辑题,Gemma 4 E4B也能通过长时间思考拿下,只是思考时间远超在线大模型的响应时间罢了。
在雷科技看来,Gemma 4 E4B已经证明,手机本地模型确实能干活。
但只有在拿它做摘要、改写、简单识图,我愿意用;可任务稍微复杂一点,尤其涉及长中文、细节判断和内容创作时,它和在线大模型之间的差距依然很明显,就更别说Agent调用一类的任务了。
要知道,从压缩率和功能性上看,Gemma 4已经是目前最强的手机端侧AI了。
想要突破这个效果,苹果只能舍弃现有的压缩方式,通过在相同的空间内塞入更大参数量的模型,或许才能让手机拥有一个不那么容易犯傻的大脑。
参数规模不重要,效率才是模型应用的关键
以前大家谈大模型,总觉得参数越多越有排面。
百亿只是起步,万亿也不嫌多,在发布会上报数字像菜市场称重,主打一个“我家萝卜,又大又壮”。
看起来没问题,但是实际运行起来就是另一回事了。
根据Jordan Hoffmann团队的Chinchilla scaling law研究,在相同训练算力下,训练数据更充分的70B模型能够全面超过欠训练的280B、530B模型,哪怕是万亿参数的MoE模型,显存占用和内存带宽依然是不小的问题。

(图源:arxiv)
更重要的是,参数如此庞大的模型,自然不可能进入消费级终端。
端侧模型想要常驻手机,就得提升效率,直面内存、功耗和散热问题。PrismML的压缩算法,算是给各家硬件厂商指明了一条路,再加上
以后大模型的进步,未必还要靠参数数字吓人。
能在不大的存储空间里稳定工作,少犯傻,少发热,关键时候真能帮上忙,这才是端侧AI下一阶段最该卷的东西。
主题为「智能伙伴·共创未来」的WAIC2026开幕在即。
AI叙事路线从模型参数堆叠,转变到Agent生产力落地;异构协同、光子计算持续提高计算上限;具身智能加速应用,机器人到家进厂让物理AI变为现实。
雷科技WAIC探展团已抵达上海,直击AI产业化落地年度巅峰时刻!

