


刚刚,DeepSeek V4 进行了一次更新。
新推出了投机解码(Speculative Decoding)框架 DSpark,并同步开源了支撑该版本的全栈推测性解码框架 DeepSpec。
DeepSeek-V4-Pro-DSpark 并非全新架构模型,而是在 DeepSeek-V4-Pro 基础上引入了推测性解码模块。此次更新的重点在于工程落地,而非模型能力本身的迭代。
DSpark 已被部署在 DeepSeek-V4(Flash 和 Pro)的真实线上流量中,大幅加速了大语言模型(LLM)的推理速度。
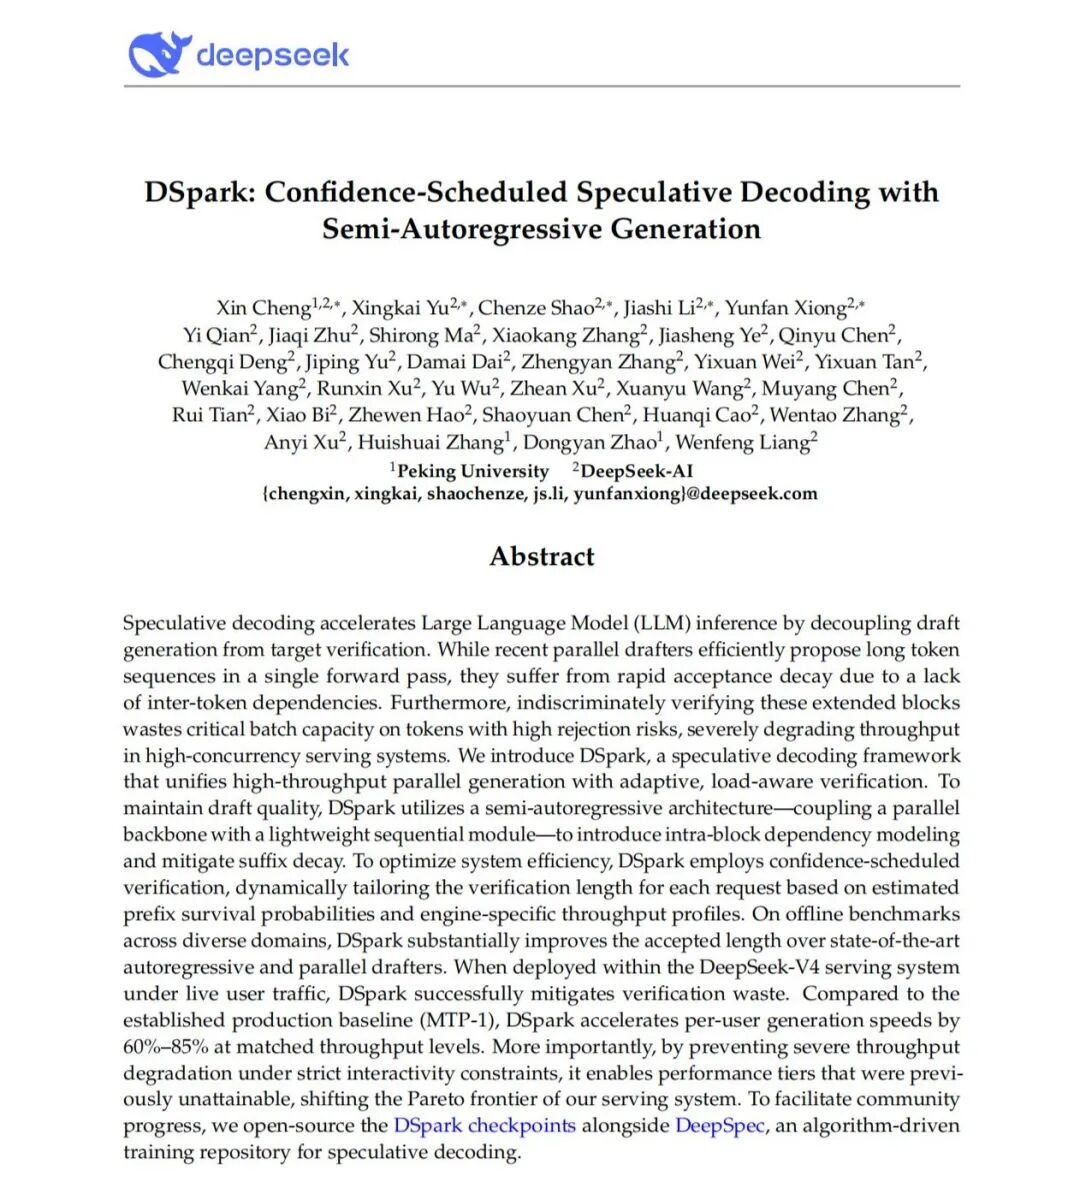
技术报告:《DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation》
技术报告链接:https://github.com/deepseek-ai/DeepSpec/blob/main/DSpark_paper.pdf
DSpark 的核心初衷是解决在生产环境中(尤其是高并发场景下)LLM 推理面临的延迟和吞吐量瓶颈。简而言之,DSpark 成功地将高吞吐量的「并行生成」与自适应的「负载感知验证」结合在了一起。
推测性解码是一种在不改变模型输出分布的前提下加速大语言模型推理的技术。其核心思路是引入一个轻量级的「草稿模型」(draft model),预先生成若干候选 token,再由目标模型(target model)对这批候选进行批量验证和接受,从而将串行逐 token 生成转变为并行批量校验,大幅降低端到端延迟。
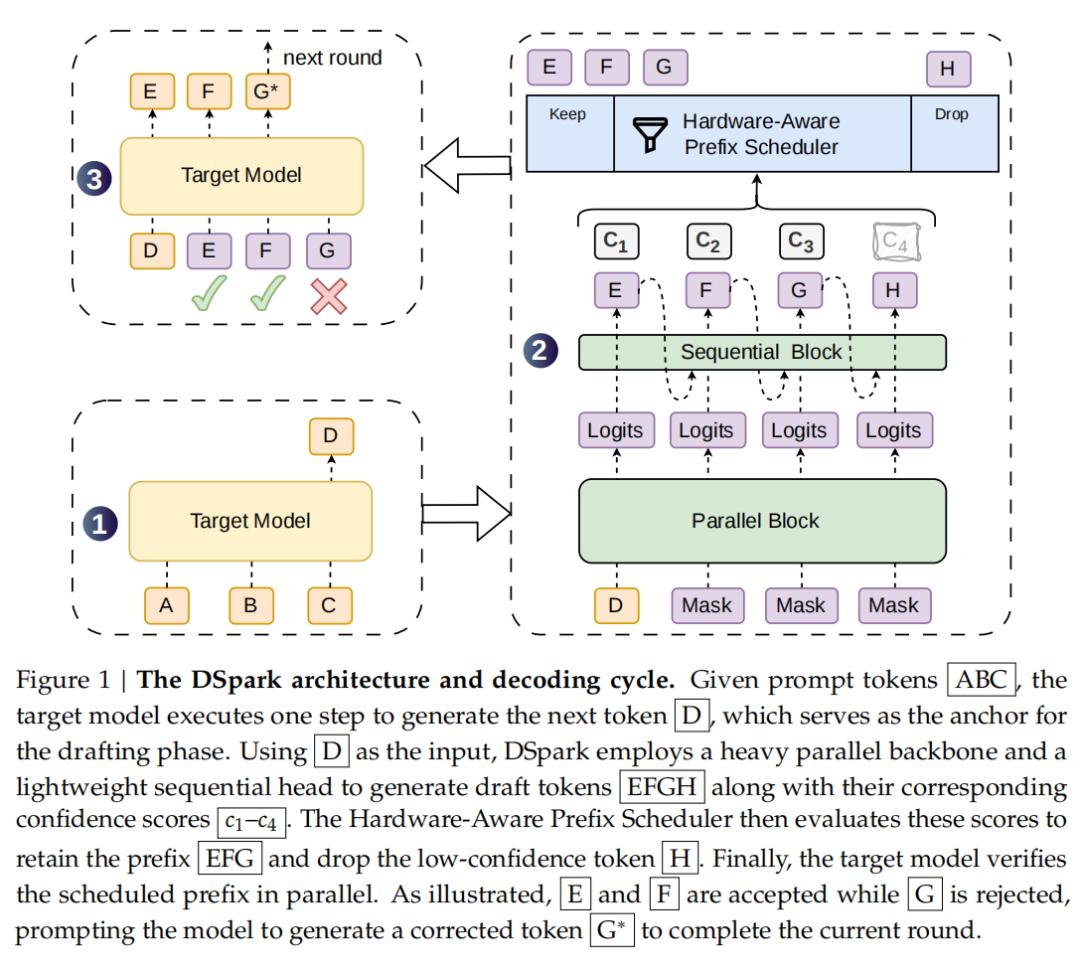
在此基础上,DSpark 的创新在于引入半自回归生成架构(Semi-Autoregressive Generation):它保留并行草稿模型的高吞吐优势,同时加入轻量级串行模块,对 block 内 token 之间的依赖关系进行建模,以缓解并行草稿模型在后续位置上容易出现的接受率衰减问题。
除此之外还有硬件感知的置信度调度验证(Confidence-Scheduled Verification):以往的投机解码通常会盲目地把生成的草稿 Token 全部送去验证,在系统高负载时,这些极大概率会被拒绝的尾部 Token 会严重浪费宝贵的批处理算力。DSpark 引入了一个置信度头(Confidence Head)来评估每个 Token 的存活概率。结合硬件感知前缀调度器,系统能够根据实时的引擎吞吐量特征,动态为每个请求量身定制最优的验证长度,将算力只分配给预期回报最高的 Token。
为了在真实的线上基础设施中落地,DSpark 的调度器采用了异步机制,以兼容零开销调度(ZOS)和连续的 CUDA 图回放。它利用前两步的历史预测来决定当前的动态截断长度,从而隐藏了调度延迟,避免了 GPU 流水线停顿,同时保证了目标模型输出分布的完全无损还原。
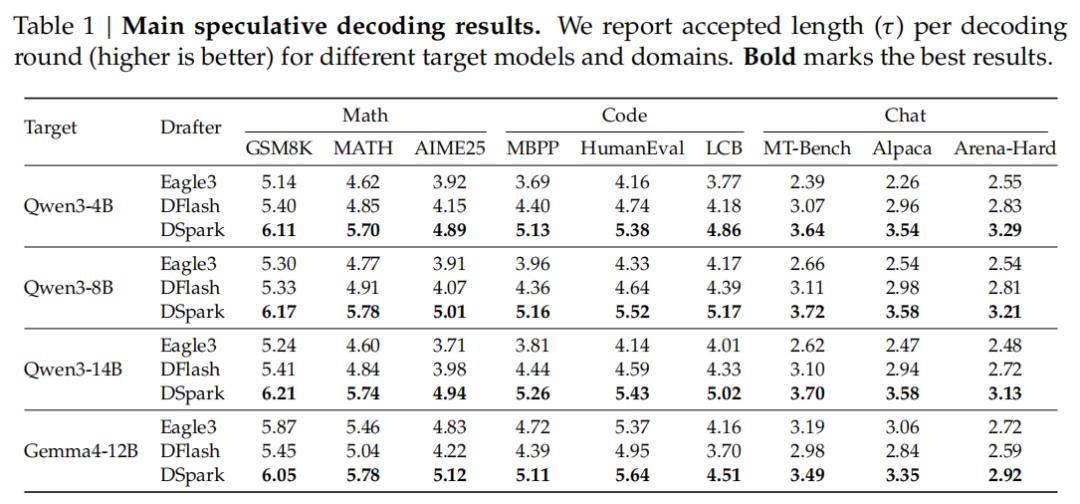
在涵盖数学推理、代码生成和日常对话等多个领域的测试中,DSpark 大幅超越了目前最先进的自回归模型(Eagle3)和并行草稿模型(DFlash)。例如,在 Qwen3 系列(4B、8B、14B)目标模型上,其平均接受长度比 Eagle3 提升了 26.7% 到 30.9%,比 DFlash 提升了 16.3% 到 18.4%。
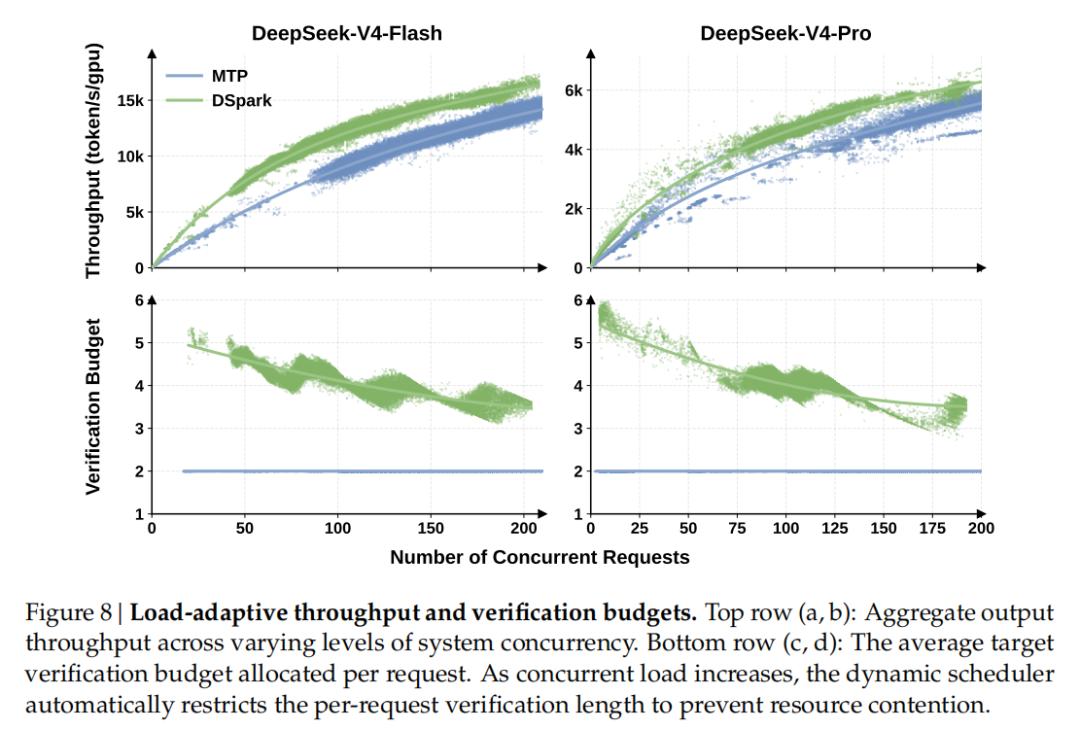
相比于前一代部署的单 Token 生产基准(MTP-1),在维持相同总体吞吐量的情况下,DSpark 将用户的生成速度分别提升了 60%-85%(Flash 模型)和 57%-78%(Pro 模型)。
随 DSpark 一同开源的还有 DeepSpec,这是一个用于训练和评估推测性解码草稿模型的全栈代码库。是承载这个方案以及其他前沿算法实现的「开源基础设施」,包含数据准备工具、草稿模型实现、训练代码和评估脚本。
DeepSpec 将整体流程拆分为三个阶段:数据准备、训练和评估。三个阶段需要按顺序运行,前一阶段的输出会作为后一阶段的输入。
数据准备阶段,需下载提示词数据、使用推理引擎对目标模型重新生成答案,并构建目标缓存(target cache)。值得注意的是,以默认的 Qwen/Qwen3-4B 配置为例,目标缓存体积可达约 38 TB,使用前需充分评估存储资源。
训练阶段可通过 bash scripts/train/train.sh 启动。该脚本会调用 train.py,并为每张可见 GPU 启动一个 worker。用户可以通过指定 config_path,在 config/ 目录下选择不同算法和目标模型配置。项目也支持通过覆盖 config_path、target_cache_dir,以及使用 --opts 修改单个配置字段来调整训练设置。
硬件方面,DeepSpec 默认配置和脚本面向单节点 8 卡环境。如果 GPU 数量较少,用户需要相应减少 CUDA_VISIBLE_DEVICES 中的可见 GPU 数量。
评估阶段则通过 bash scripts/eval/eval.sh 启动。评估脚本会使用训练好的草稿模型 checkpoint,在多个 speculative decoding 基准任务上衡量接受情况。项目当前列出的评估数据集包括 GSM8K、MATH500、AIME25、HumanEval、MBPP、LiveCodeBench、MT-Bench、Alpaca 和 Arena-Hard-v2,覆盖数学推理、代码生成、对话能力和综合问答等不同任务类型。
算法方面,DeepSpec 目前内置三种草稿模型:DSpark、DFlash 和 Eagle3。目标模型系列方面,项目当前支持 Qwen3 和 Gemma。
DeepSpec 的开源,将推测性解码这一此前多散落于各研究团队内部的工程实践,整合为一套可复现、可扩展的标准化工具链。对于希望为自有大模型加速推理的研究者和工程师而言,这意味着可以直接在成熟框架上训练定制草稿模型,跳过大量重复的基础设施搭建工作。
参考链接:
https://github.com/deepseek-ai/DeepSpec/blob/main/DSpark_paper.pdf
https://github.com/deepseek-ai/DeepSpec
本文来自微信公众号 “机器之心”(ID:almosthuman2014),作者:泽南、杨文 ,36氪经授权发布。
