


Transformer统治地位悬了!一款SubQ模型带着SAA架构横空出世,1200万上下文成本仅Opus的5%,计算量暴减千倍。
Transformer,王座不保?!
今天,一款AI模型SubQ横空出世,震撼了全世界。
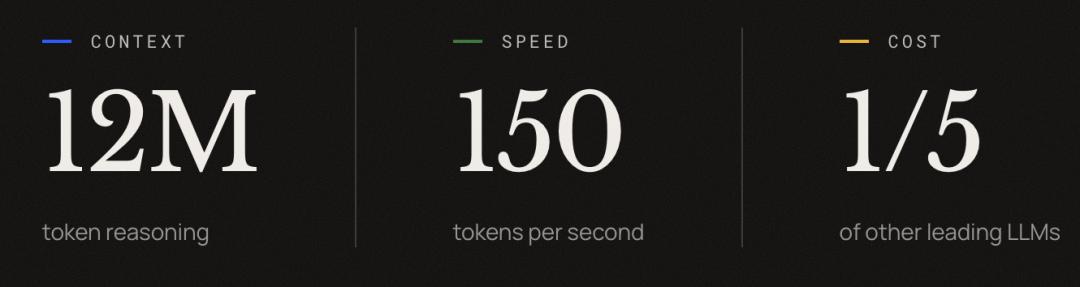
这是全球首个基于完全亚二次方稀疏注意力架构(SSA)的模型,上下文高达1200万Token。
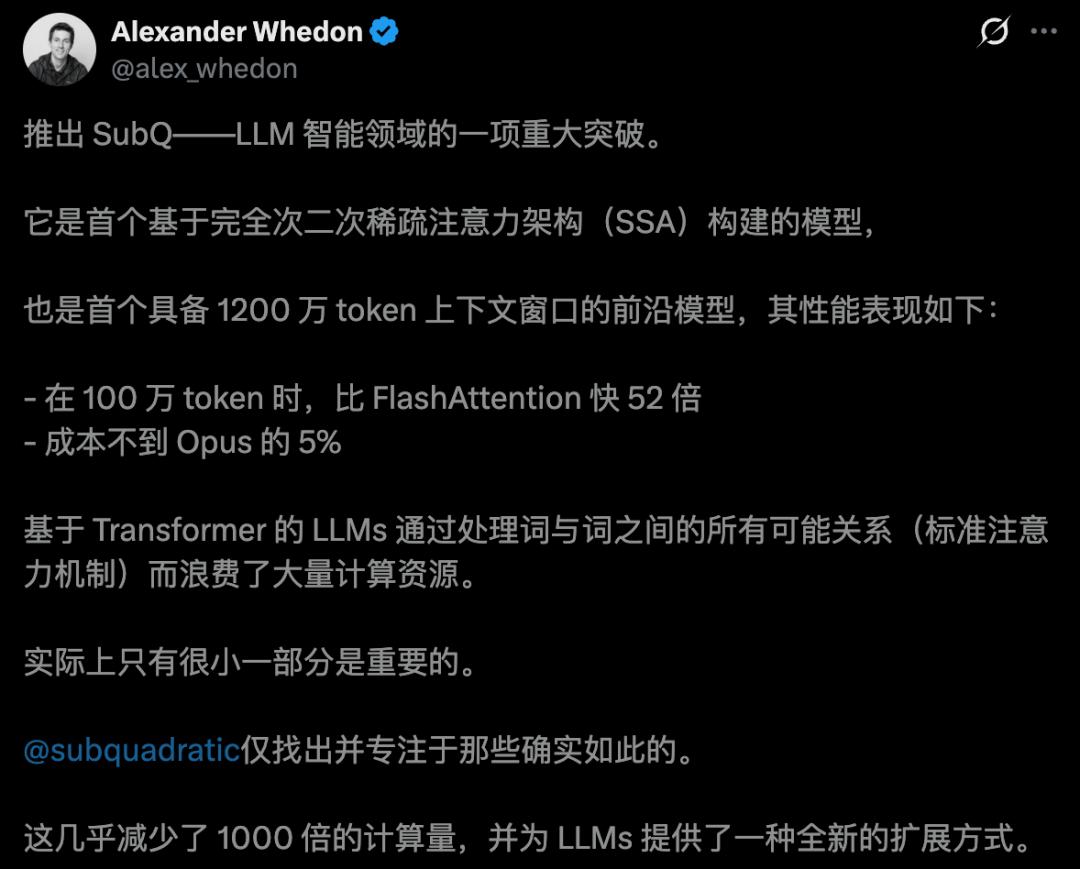
SubQ的核心优势在于,其SSA架构会根据内容「动态选择」关注点,不会盲目计算所有Token间的关联。
相较于Transformer,它的计算量直接暴减1000倍。
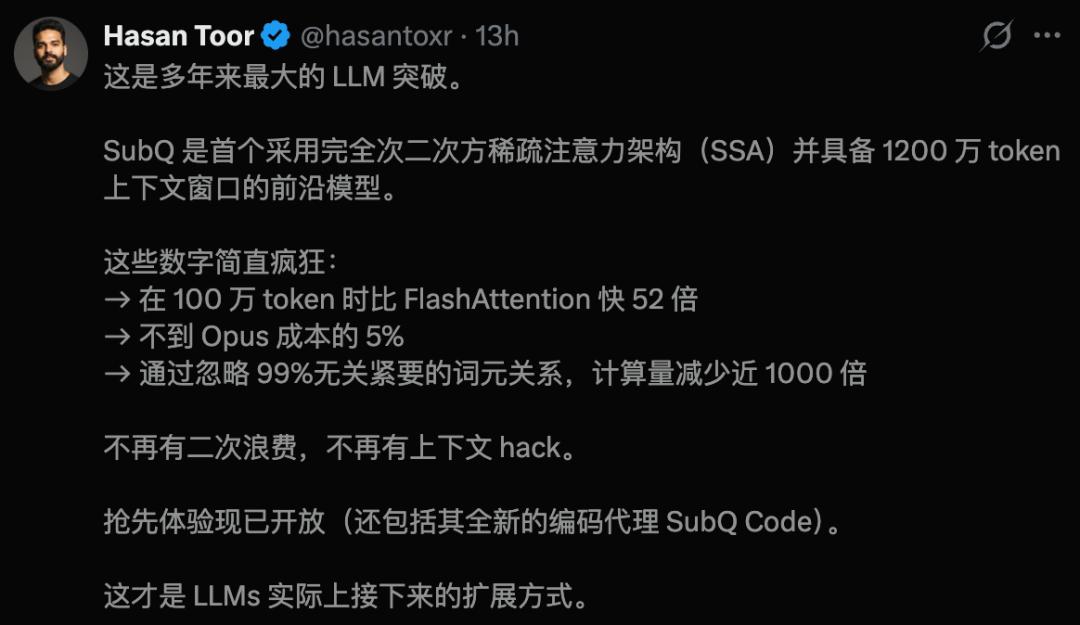
实验结果显示,100万token上下文,SubQ要比FlashAttention快52倍,成本不到Claude Opus的5%。
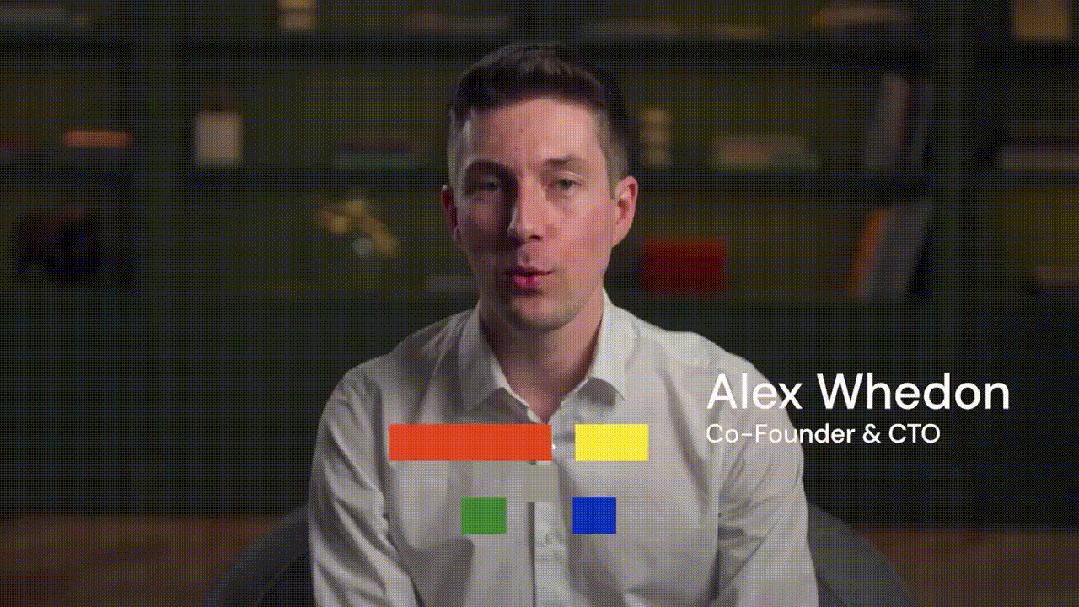
而打造出这款架构的背后这家公司,叫Subquadratic,坐标迈阿密,全公司仅13人。
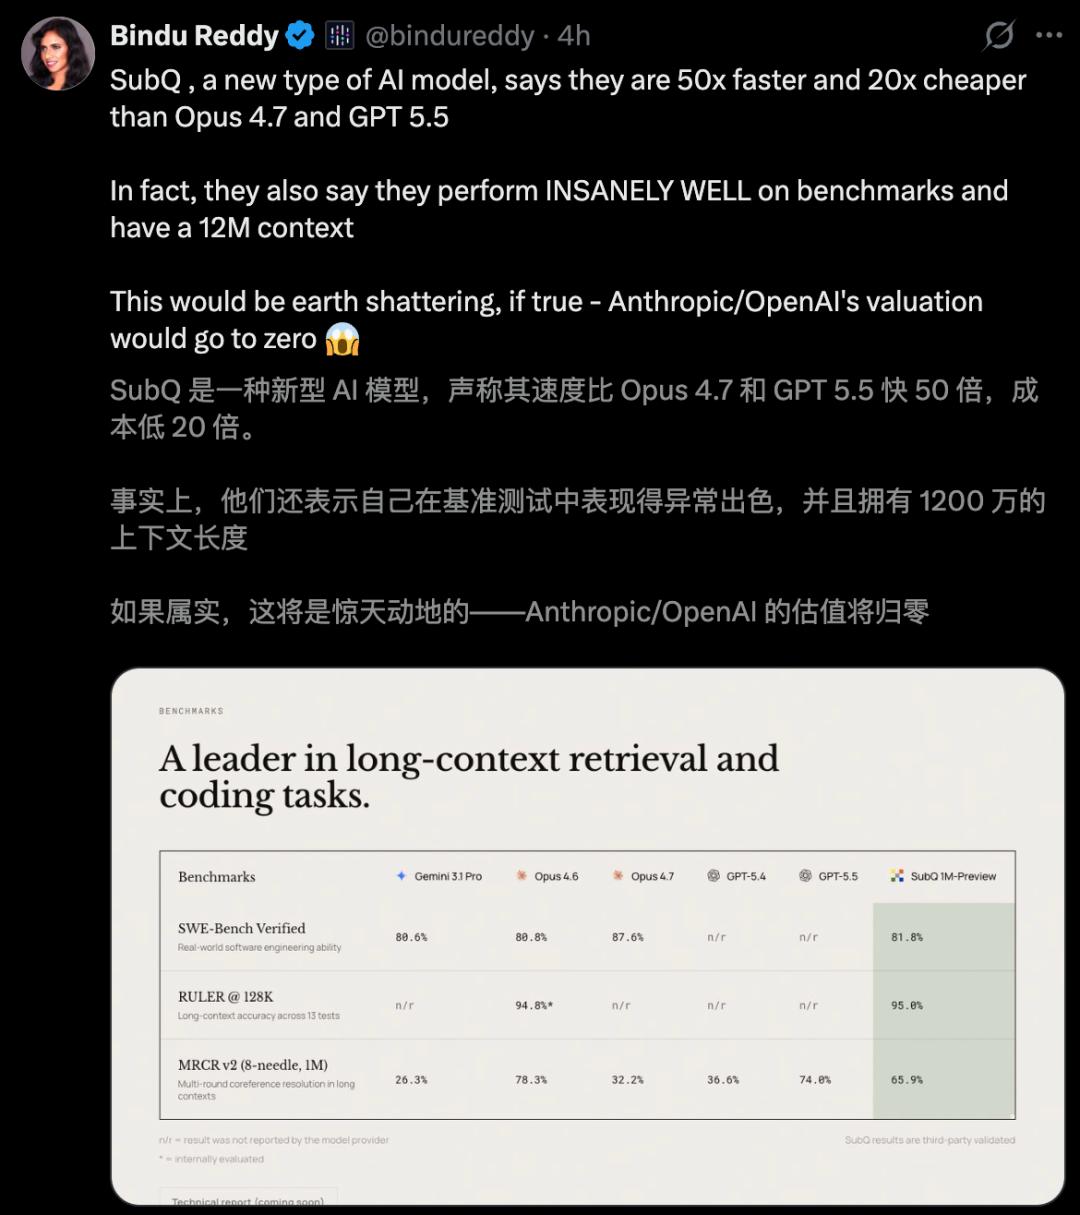
AI大佬Bindu Reddy辣评道,「若这一切都是真的,Anthropic和OpenAI的估值直接归0」!
还有人表示,这才是LLM接下来真正Scaling的方式。
Transformer「原罪」,九年未解
2017年,谷歌那篇「Attention is All You Need」奠定了Transformer架构的统治地位。
此后九年,从GPT到Claude到Gemini,所有前沿大模型都建立在同一个基础上:密集注意力机制。
长期以来,Transformer的工作方式非常暴力,即每个token都要和序列中所有其他token做一次比较。
这种机制让它深陷「二次方复杂度」的泥潭,上下文每增加一倍,计算成本飙升四倍。
这意味着,输入越长,模型越贵、越慢、越容易崩。
这就解释了几乎所有LLM的上下文卡在100万token左右,不是技术做不到更长,是做到了也用不起。
这一次,SubQ的诞生,从根本上改变了这个等式。
SSA架构出世,不要「更快」只要「更少」
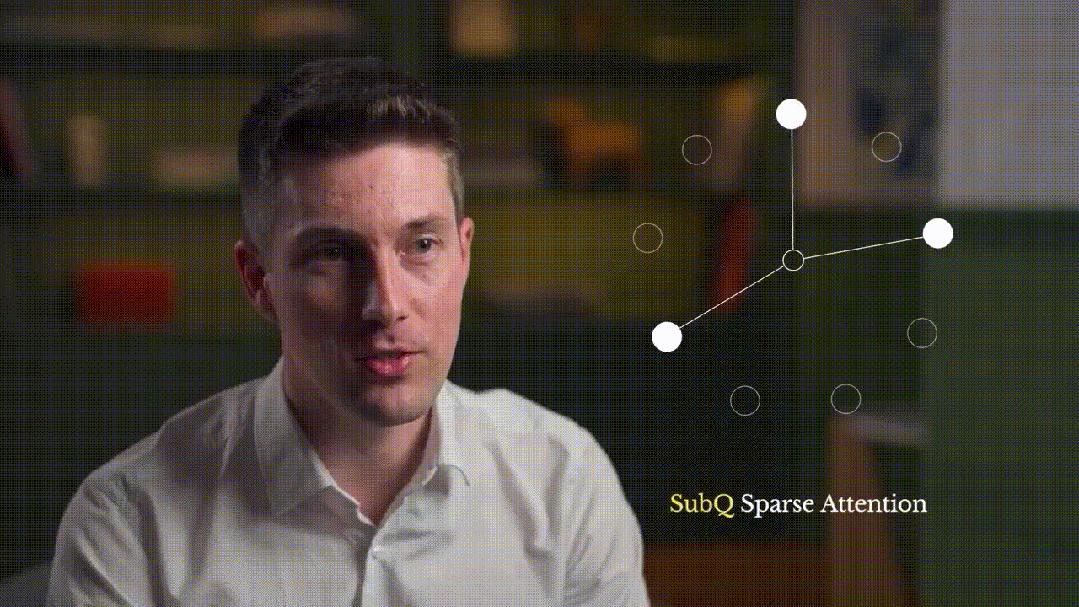
SubQ的核心突破叫做SSA——亚二次方稀疏注意力(Subquadratic Sparse Attention)。
它的思路出奇地简单,不再让每个token和所有token做比较。
既然训练好的模型中,绝大多数注意力权重都接近零0,那为什么还要算它们?
SSA的做法是,对每一个query,基于「内容」选择序列中真正值得关注的位置,然后只在这些位置上精确计算注意力。
它只计算那些真正有意义的交互,跳过其余99%以上的无用计算。
以下是SSA的三大关键特性——
线性扩展
计算量随选中的位置数量增长,而不是随整个序列长度增长。上下文翻倍,成本只翻倍,不再是翻四倍。
内容依赖路由
模型根据语义决定看哪里,而不是根据位置。关键信息在序列第3个token还是第1100万个token,都能被找到。
精确检索
不像循环模型那样把信息压缩成固定状态,SSA保留了从任意位置精确取回信息的能力。
说白了,SSA不是「把密集注意力算得更快」,而是「让模型做更少的注意力计算」。
减少的计算量,直接转化为速度。
速度狂飙52.5倍,成本不到Opus 5%
SubQ放出的数据,每一条都在暴击:
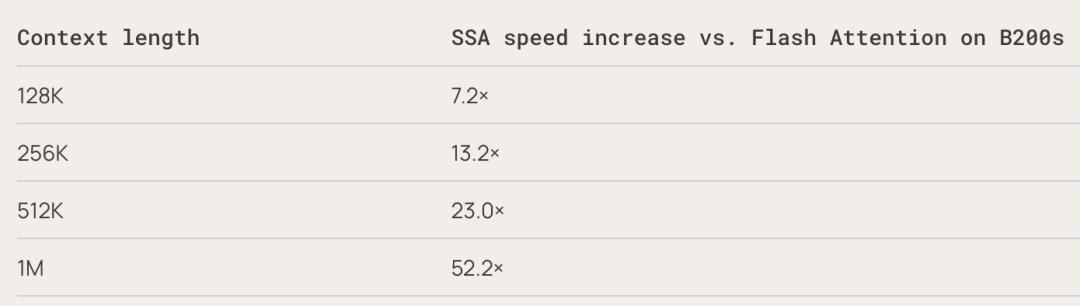
在100万token长度上,SSA比标准密集注意力+FlashAttention-2快52.2倍。
在12.8万token上快7.2倍,25.6万token快13.2倍,51.2万token快23倍。
显而易见,上下文越长,优势越碾压。
这正是SSA线性扩展的直接体现——密集注意力越长越慢,SSA越长越划算。
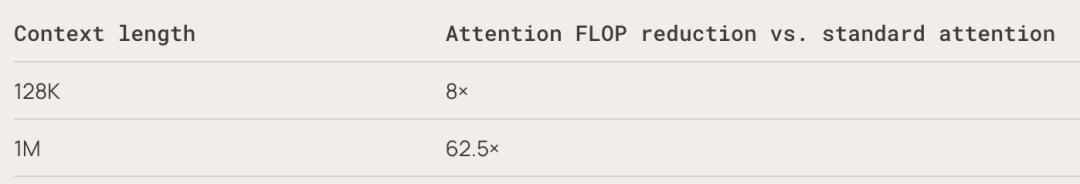
再来看算力消耗,在100万token下,注意力FLOP减少了62.5倍。在1200万token下,这个数字飙升到接近1000倍。
至于成本,Subquadratic给了一个非常直观的对比——
在RULER 128K基准测试上,SubQ花费8美元,Opus为2600美元,直接拉出了300倍的成本差距。
最关键的是,这些速度和成本优势,并没有以牺牲准确率为代价。
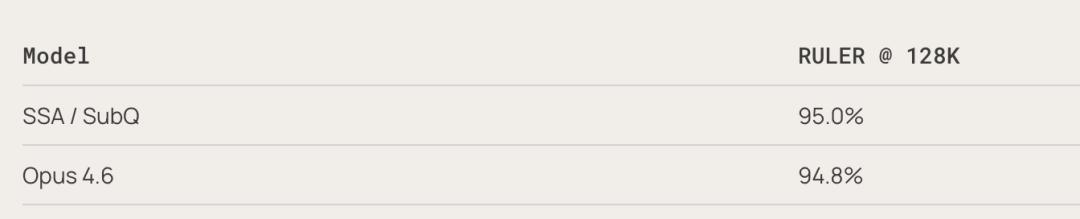
RULER 128K基准测试: SubQ拿下95%,Opus 4.6是94.8%;
SWE-Bench Verified(代码工程): SubQ得分81.8,超过Opus 4.6的80.8。
MRCR v2(长上下文检索): SubQ拿到65.9%,虽然低于Opus 4.6的78%,但远超GPT 5.4(39%)和Gemini 3.1 Pro(23%)。
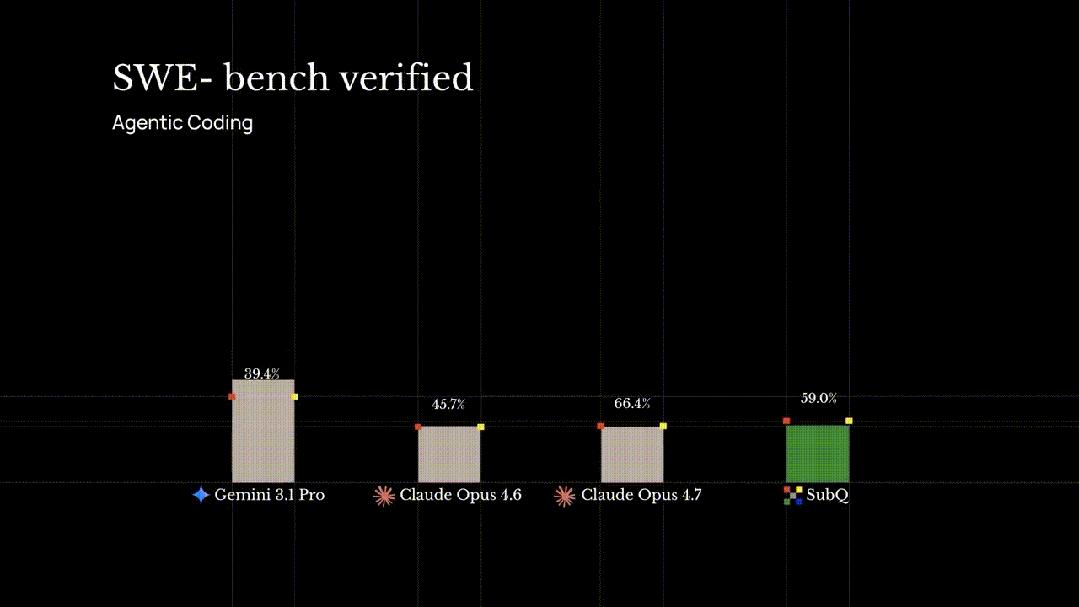
这组数字放在一起看,细思极恐——
一家种子轮公司,用不到Opus 5%的成本,在多项核心基准测试上打平甚至超过了Anthropic和OpenAI的旗舰模型。
一个提示词,SubQ即可处理1200万Token的超长信息:
无论是整个代码库、数月的 PR 记录,还是长期运行的 AI 智能体状态,全都游刃有余,而且成本仅需原来的五分之一。
不得不说,若这一切成真,这将是Transformer问世以来最重要的架构级突破。
13人初创公司,要颠覆Transformer
Subquadratic成立于2024年,拿下2900万美元种子轮,估值5亿美元。
它有两位联合创始人:CEO Justin Dangel,CTO Alexander Whedon。
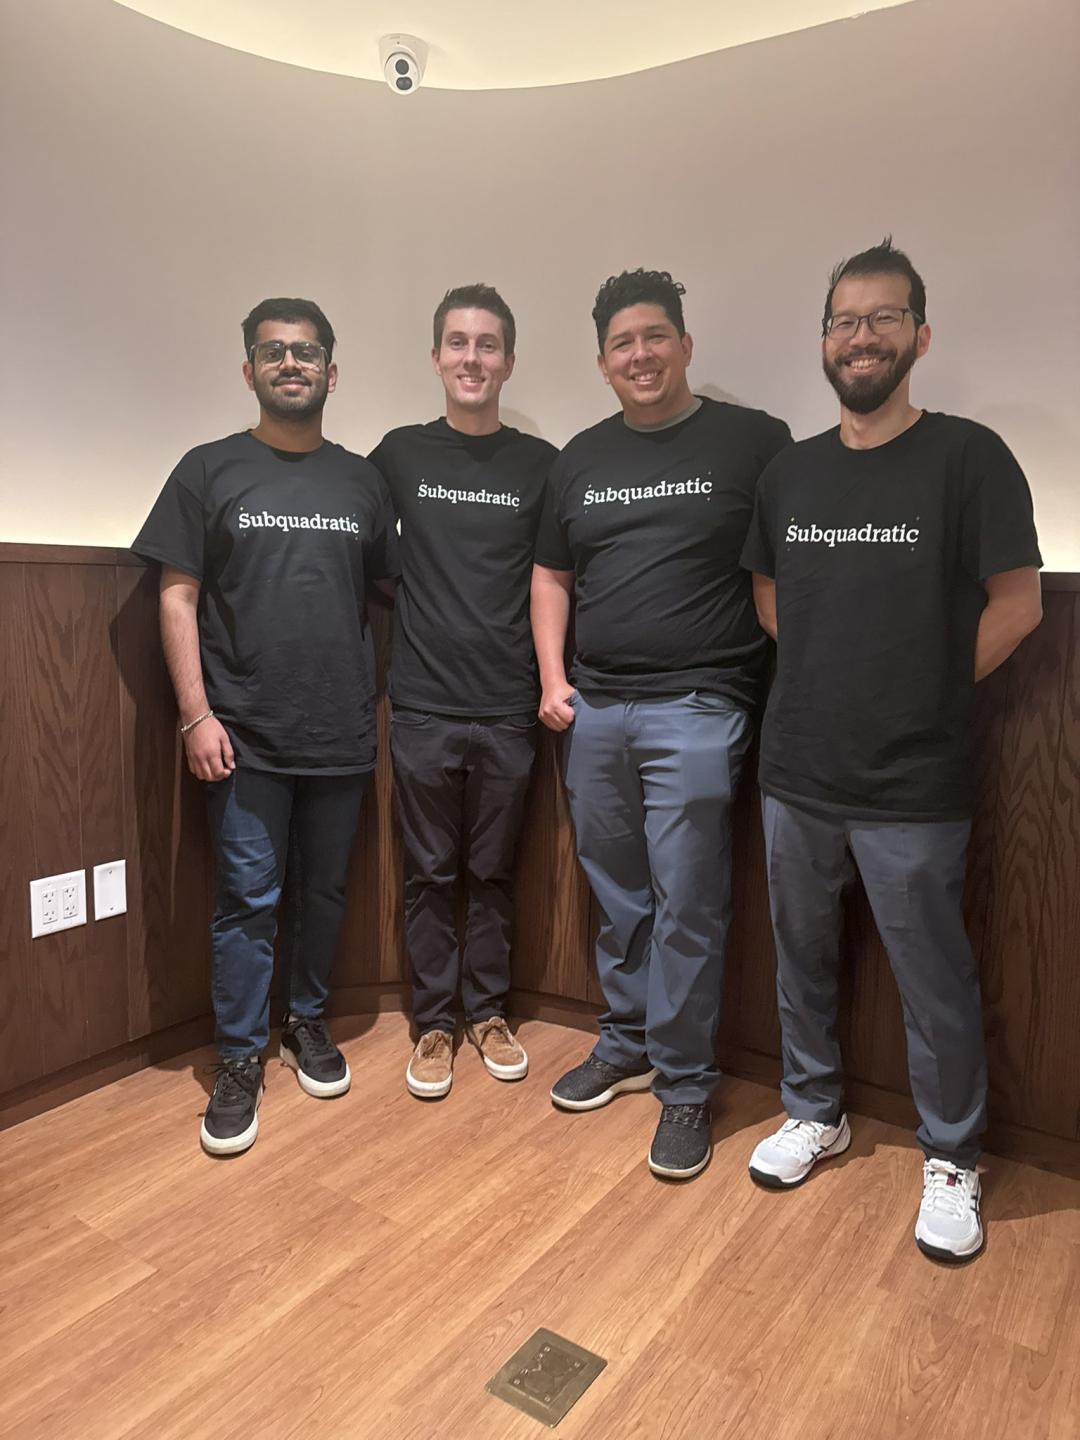
研究团队11人,全部是博士,来自Meta、谷歌、牛津大学、剑桥大学、Adobe。
值得一提的是,这家公司之前叫Aldea,做的是语音模型,后来转型到了注意力架构研究。
这一次,产品线三条同时上线:
SubQ API:12M token全量上下文接口
SubQ Code:命令行编码Agent,整个代码库一次性塞进去
SubQ Search:深度研究工具,初期免费
全网炸锅:是终结者,还是AI版Theranos?
SubQ发布后数小时内,AI社区就分裂成了两个阵营。
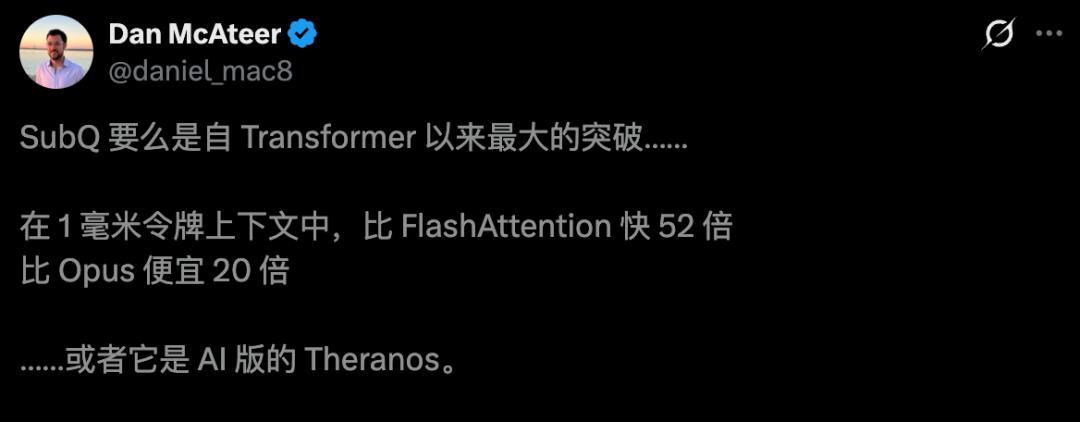
AI大佬Dan McAteer一句话,概括了所有人的心态:
SubQ要么是Transformer以来最大的突破……
要么就是AI界的Theranos。
支持者一方阵容不小。
有人表示,这是2026年最疯狂的AI发布之一。
Subquadratic可能找到了奥特曼所言的另一个架构的重大突破。


但怀疑派也毫不留情,有人直言这就是一个「骗子公司」,尤其是看完创始人领英介绍后。


OpenAI前研究员Will Depue更是连发多条,第一时间指出,「SubQ几乎可以确定是基于Kimi或DeepSeek的稀疏注意力微调」。


AI圈见过太多「发布即巅峰」的故事,发布会上的PPT和真实世界的部署之间,隔着一整条死亡谷。
但话说回来,也正因为这个赌注太大,整个行业才不敢不认真对待。
答案,也许只有等技术报告公开、独立benchmark复现之后,才会真正揭晓。
参考资料:
https://x.com/alex_whedon/status/2051663268704636937?s=20
https://subq.ai/how-ssa-makes-long-context-practical
https://x.com/daniel_mac8/status/2051710659822305661?s=20
本文来自微信公众号“新智元”,作者:新智元,36氪经授权发布。
