


日前,来自清华大学、智谱的研究团队联合推出了 Vision2Web,这是一个旨在评估多模态代码 Agent 真实开发能力的分层级基准。
与以往局限于静态页面生成或局部代码修复的测试不同,该研究揭示了一个关键现象:
随着任务复杂度从简单的 UI 还原升级到全栈系统构建,即便是目前的 SOTA 模型,其性能也会出现显著下降。
据论文描述,Vision2Web 通过构建包含静态网页、交互前端到全栈网站的三级进阶任务,结合工作流式的 Agent 验证机制,填补了现有评估体系的空白,为理解 AI 在长程、跨模态软件工程中的能力边界提供了全新视角。
论文链接:https://arxiv.org/abs/2603.26648
核心设计
Vision2Web 将网站开发任务划分为三个难度递增的层级,每个层级对应不同的能力要求。
层级一:静态网页
该层级评估模型对用户界面的理解能力以及在设备响应式场景下的代码生成能力。模型需依据同一网页在桌面、平板及移动设备上的多张原型图与分辨率规格,生成能够在不同终端下保持布局与样式一致的响应式页面。
层级二:交互式前端
该层级要求模型在接收多张原型图及描述页面间逻辑关系的文本输入后,构建出具备完整导航流且结构高度一致的多页面前端应用,以此考察其跨模态的页面组织与逻辑推理能力。
层级三:全栈网站
作为对工程能力的终极考核,全栈网站开发任务则要求模型面对结构化的需求文档与复杂原型图,统筹需求理解、状态管理及集成调试等全链路工作,最终交付一个逻辑自洽、功能完备的可运行全栈系统。
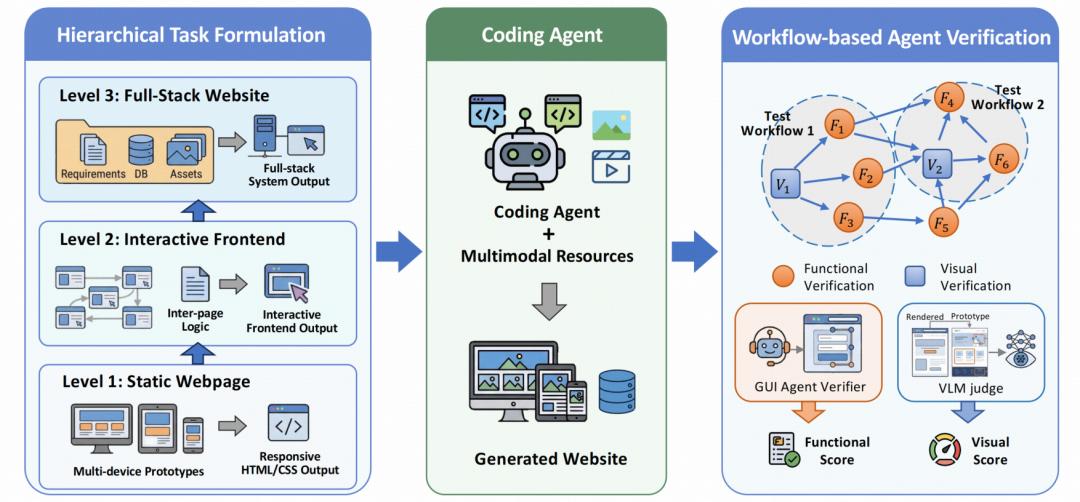
图 | Vision2Web 视觉网站开发层级基准测试系统概述。该系统涵盖三个层级任务:静态网页、交互式前端界面及全栈网站,要求 Agent 将视觉原型与文本规范进行整合。评估采用基于工作流的 Agent 验证范式,通过功能正确性与视觉保真度双重指标进行量化分析。
在数据集构建方面,Vision2Web 筛选并整合了大量真实世界的网站资源,最终包含了 193 个开发任务,广泛覆盖内容、交易、SaaS 平台及公共服务4个类别下的 16 个子类,总计配备了 918 张原型图像和 1255 个测试用例,旨在为评估模型在多样化、高复杂度场景下的泛化能力提供坚实且高质量的数据基础。
评估与结果
为解决端到端网站评估中功能测试与视觉测试的挑战,Vision2Web 采用基于工作流的 Agent 验证范式。该范式将测试过程组织为有向依赖图,每个节点对应一个验证子程序,节点间编码顺序依赖与共享状态。
验证节点分为两类:
功能验证节点:由 GUI Agent 执行,依据目标、引导动作与验证标准判断功能正确性,输出功能得分。
视觉验证节点:由 VLM 评判器执行,对渲染页面与原型进行组件级比较,输出视觉得分。
基于此,研究团队在预配置的容器化环境中,对 Claude-Opus-4.5、GPT-5、Gemini-3-Pro 等多个前沿模型进行了全面测试。主要有以下六个发现:
发现一:模型能力随任务复杂度提升而呈现显著下降的趋势。例如 Gemini-3-Pro-Preview 在静态桌面端得分为 63.3,但在全栈任务中视觉得分骤降至 11.7,功能得分仅为 22.6。
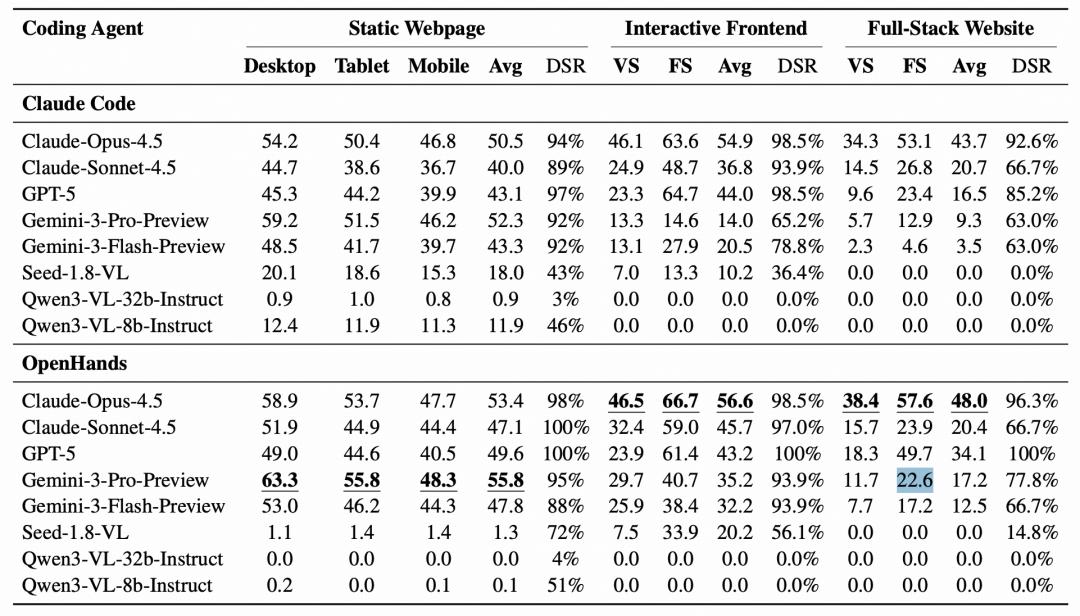
图 | 多模态编码 Agent 在Vision2Web 数据集上三个任务层级的端到端性能表现,报告指标包括设备级静态评分、交互式任务与全栈任务的平均功能评分(FS)及视觉评分(VS),其中部署成功率(DSR)仅作参考用途而非官方指标。除非特别说明,所有指标均采用 0-100 分量表进行报告。
发现二:模型在设备适应性上存在明显短板,平板与移动端的视觉表现普遍比桌面端低 10%-20%。
发现三:模型间表现差异明显。在横向对比中,Claude-Opus-4.5 表现最为鲁棒。
发现四:框架选择影响结果。多数模型在 OpenHands 框架下的表现优于 Claude Code。
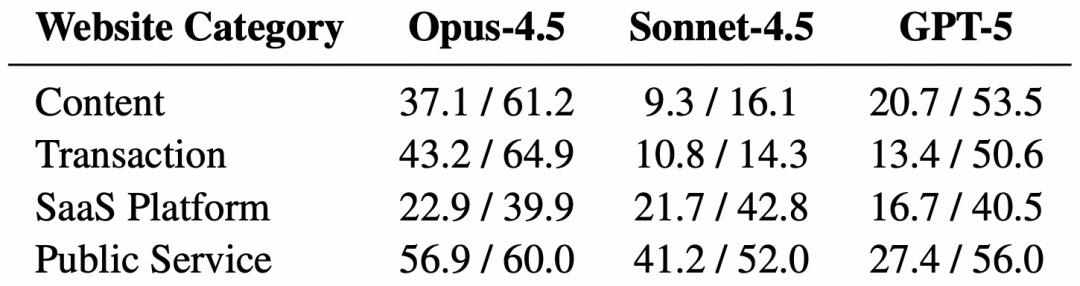
图 | 在 Vision2Web 平台的 OpenHands 框架下,不同网站类别中选定编码 Agent 的性能表现(视觉评分/功能评分)。Opus-4.5 与 Sonnet-4.5 分别对应 Claude-Opus-4.5 和 Claude-Sonnet-4.5。
发现五:网站类别影响表现。模型在结构简单的公共服务类网站上表现最佳,而在交互复杂的 SaaS 平台上最为吃力。
发现六:功能类别差异显著。导航与认证等基础逻辑通过率较高,但在状态管理、增删改查及文件操作等涉及复杂数据流转的任务上,所有模型均暴露出明显的短板。
总结与展望
实验显示,随着任务复杂度从静态页面向全栈系统攀升,模型的性能出现断崖式下跌。
在基础层级,模型常因过度依赖文件名而缺乏稳健的多模态基础,导致在处理未命名资源或规则组件时出现布局错位和视觉不一致。
进入多页面交互阶段,这种缺陷演变为跨视图的连贯性缺失,模型往往能较好地复现主页,却无法维持后续页面的视觉保真度与交互逻辑。
在最复杂的全栈系统层面,由于缺乏可靠的自主验证机制,模型在长上下文中容易偏离需求规范,导致项目无法启动或运行崩溃。
这些发现深刻暴露了当前 Agent 在整体任务管理和系统级工程化方面的局限性。在孤立任务上的强性能并不能可靠地转化为端到端系统构建,揭示了在处理结构复杂性、跨页面协调和持久状态推理方面的系统性缺陷。
展望未来,研究不能仅满足于单点代码生成的准确性,更应聚焦于分层、渐进挑战的任务设计以及基于原则、可复现的自主评估范式,作为严谨理解和评估 Coding Agent 能力的基础。
本文来自微信公众号 “学术头条”(ID:SciTouTiao),作者:王跃然,36氪经授权发布。
